

Di balik layar browser web modern

Pengantar
Panduan komprehensif tentang operasi internal WebKit dan Gecko ini adalah hasil dari banyak riset yang dilakukan oleh developer Israel, Tali Garsiel. Selama beberapa tahun, dia meninjau semua data yang dipublikasikan tentang internal browser dan menghabiskan banyak waktu untuk membaca kode sumber browser web. Dia menulis:
Sebagai developer web, mempelajari internal operasi browser akan membantu Anda membuat keputusan yang lebih baik dan mengetahui alasan di balik praktik terbaik pengembangan. Meskipun dokumen ini agak panjang, sebaiknya Anda meluangkan waktu untuk mempelajarinya. Anda tidak akan kecewa.
Paul Irish, Hubungan Developer Chrome
Pengantar
Browser web adalah software yang paling banyak digunakan. Dalam panduan ini, saya akan menjelaskan cara
kerjanya di balik layar. Kita akan melihat apa yang terjadi saat Anda mengetik google.com
di kolom URL hingga Anda melihat halaman Google di layar browser.
Browser yang akan kita bahas
Ada lima browser utama yang digunakan di desktop saat ini: Chrome, Internet Explorer, Firefox, Safari, dan Opera. Di perangkat seluler, browser utamanya adalah Android Browser, iPhone, Opera Mini dan Opera Mobile, UC Browser, browser Nokia S40/S60, dan Chrome. Semua browser tersebut, kecuali browser Opera, didasarkan pada WebKit. Saya akan memberikan contoh dari browser open source Firefox dan Chrome, serta Safari (yang sebagian bersifat open source). Menurut statistik StatCounter (per Juni 2013), Chrome, Firefox, dan Safari mencakup sekitar 71% penggunaan browser desktop global. Di perangkat seluler, Browser Android, iPhone, dan Chrome mencakup sekitar 54% penggunaan.
Fungsi utama browser
Fungsi utama browser adalah menampilkan resource web yang Anda pilih, dengan memintanya dari server dan menampilkannya di jendela browser. Resource biasanya berupa dokumen HTML, tetapi mungkin juga berupa PDF, gambar, atau jenis konten lainnya. Lokasi resource ditentukan oleh pengguna menggunakan URI (Uniform Resource Identifier).
Cara browser menafsirkan dan menampilkan file HTML ditentukan dalam spesifikasi HTML dan CSS. Spesifikasi ini dikelola oleh organisasi W3C (World Wide Web Consortium), yang merupakan organisasi standar untuk web. Selama bertahun-tahun, browser hanya mematuhi sebagian spesifikasi dan mengembangkan ekstensi mereka sendiri. Hal ini menyebabkan masalah kompatibilitas yang serius bagi pembuat web. Saat ini, sebagian besar browser kurang lebih sesuai dengan spesifikasi.
Antarmuka pengguna browser memiliki banyak kesamaan satu sama lain. Di antara elemen antarmuka pengguna yang umum adalah:
- Kolom URL untuk menyisipkan URI
- Tombol kembali dan maju
- Opsi bookmark
- Tombol muat ulang dan berhenti untuk memuat ulang atau menghentikan pemuatan dokumen saat ini
- Tombol Beranda yang mengarahkan Anda ke halaman beranda
Anehnya, antarmuka pengguna browser tidak ditentukan dalam spesifikasi formal apa pun, melainkan hanya berasal dari praktik baik yang dibentuk selama bertahun-tahun pengalaman dan oleh browser yang saling meniru. Spesifikasi HTML5 tidak menentukan elemen UI yang harus dimiliki browser, tetapi mencantumkan beberapa elemen umum. Di antaranya adalah kolom URL, status bar, dan toolbar. Tentu saja, ada fitur unik untuk browser tertentu seperti pengelola download Firefox.
Infrastruktur tingkat tinggi
Komponen utama browser adalah:
- Antarmuka pengguna: ini mencakup kolom URL, tombol kembali/maju, menu bookmark, dll. Setiap bagian dari tampilan browser kecuali jendela tempat Anda melihat halaman yang diminta.
- Mesin browser: mengarahkan tindakan antara UI dan mesin rendering.
- Mesin rendering: bertanggung jawab untuk menampilkan konten yang diminta. Misalnya, jika konten yang diminta adalah HTML, mesin rendering akan mengurai HTML dan CSS, serta menampilkan konten yang diurai di layar.
- Jaringan: untuk panggilan jaringan seperti permintaan HTTP, menggunakan implementasi yang berbeda untuk platform yang berbeda di balik antarmuka yang tidak bergantung pada platform.
- Backend UI: digunakan untuk menggambar widget dasar seperti kotak kombinasi dan jendela. Backend ini mengekspos antarmuka umum yang tidak spesifik untuk platform tertentu. Di balik layar, library ini menggunakan metode antarmuka pengguna sistem operasi.
- Penafsir JavaScript. Digunakan untuk mengurai dan mengeksekusi kode JavaScript.
- Penyimpanan Data. Ini adalah lapisan persistensi. Browser mungkin perlu menyimpan berbagai jenis data secara lokal, seperti cookie. Browser juga mendukung mekanisme penyimpanan seperti localStorage, IndexedDB, WebSQL, dan FileSystem.
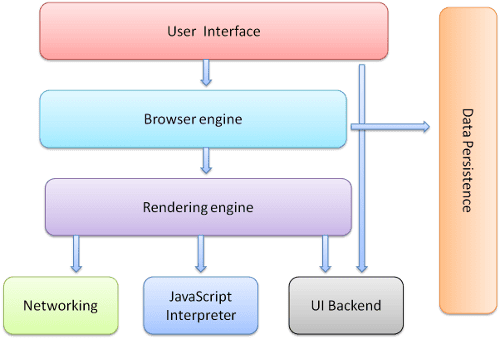
Penting untuk diperhatikan bahwa browser seperti Chrome menjalankan beberapa instance mesin rendering: satu untuk setiap tab. Setiap tab berjalan dalam proses terpisah.
Mesin rendering
Tanggung jawab mesin rendering adalah… Rendering, yaitu menampilkan konten yang diminta di layar browser.
Secara default, mesin rendering dapat menampilkan dokumen dan gambar HTML dan XML. Browser dapat menampilkan jenis data lain melalui plugin atau ekstensi; misalnya, menampilkan dokumen PDF menggunakan plugin penampil PDF. Namun, dalam bab ini, kita akan berfokus pada kasus penggunaan utama: menampilkan HTML dan gambar yang diformat menggunakan CSS.
Browser yang berbeda menggunakan mesin rendering yang berbeda: Internet Explorer menggunakan Trident, Firefox menggunakan Gecko, Safari menggunakan WebKit. Chrome dan Opera (mulai versi 15) menggunakan Blink, fork dari WebKit.
WebKit adalah mesin rendering open source yang awalnya merupakan mesin untuk platform Linux dan dimodifikasi oleh Apple untuk mendukung Mac dan Windows.
Alur utama
Mesin rendering akan mulai mendapatkan konten dokumen yang diminta dari lapisan jaringan. Hal ini biasanya akan dilakukan dalam potongan 8 kB.
Setelah itu, berikut adalah alur dasar mesin rendering:
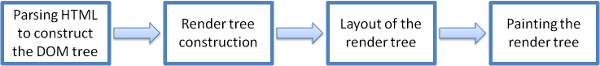
Mesin rendering akan mulai mengurai dokumen HTML dan mengonversi elemen menjadi node DOM dalam hierarki yang disebut "hierarki konten". Mesin akan mengurai data gaya, baik dalam file CSS eksternal maupun dalam elemen gaya. Informasi gaya bersama dengan petunjuk visual dalam HTML akan digunakan untuk membuat hierarki lain: hierarki render.
Hierarki render berisi persegi panjang dengan atribut visual seperti warna dan dimensi. Persegi panjang berada dalam urutan yang benar untuk ditampilkan di layar.
Setelah pembuatan hierarki render, proses "tata letak" akan dijalankan. Artinya, setiap node diberi koordinat yang tepat di mana node tersebut akan muncul di layar. Tahap berikutnya adalah rendering - hierarki render akan dilalui dan setiap node akan dirender menggunakan lapisan backend UI.
Penting untuk dipahami bahwa ini adalah proses bertahap. Untuk pengalaman pengguna yang lebih baik, mesin rendering akan mencoba menampilkan konten di layar secepat mungkin. Browser tidak akan menunggu hingga semua HTML diuraikan sebelum mulai membangun dan menata letak hierarki render. Bagian konten akan diurai dan ditampilkan, sementara prosesnya berlanjut dengan konten lainnya yang terus masuk dari jaringan.
Contoh alur utama
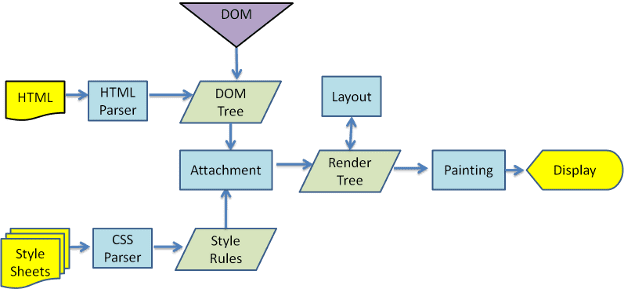
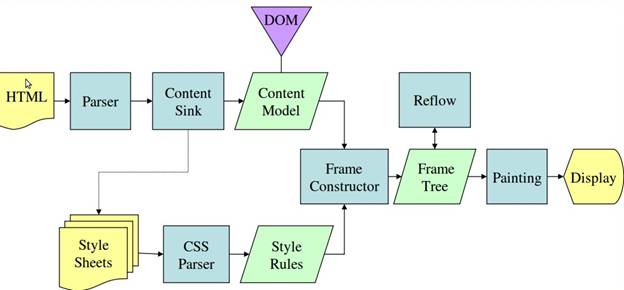
Dari gambar 3 dan 4, Anda dapat melihat bahwa meskipun WebKit dan Gecko menggunakan terminologi yang sedikit berbeda, alurnya pada dasarnya sama.
Gecko menyebut hierarki elemen yang diformat secara visual sebagai "Hierarki frame". Setiap elemen adalah frame. WebKit menggunakan istilah "Pohon Render" dan terdiri dari "Objek Render". WebKit menggunakan istilah "tata letak" untuk penempatan elemen, sedangkan Gecko menyebutnya "Reflow". "Lampiran" adalah istilah WebKit untuk menghubungkan node DOM dan informasi visual untuk membuat hierarki render. Perbedaan non-semantik kecil adalah Gecko memiliki lapisan tambahan antara HTML dan hierarki DOM. Ini disebut "sink konten" dan merupakan factory untuk membuat elemen DOM. Kita akan membahas setiap bagian dari alur:
Penguraian - Umum
Karena penguraian adalah proses yang sangat penting dalam mesin rendering, kita akan membahasnya lebih dalam. Mari kita mulai dengan sedikit pengantar tentang penguraian.
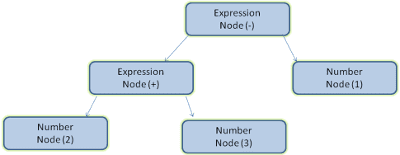
Mengurai dokumen berarti menerjemahkannya ke dalam struktur yang dapat digunakan oleh kode. Hasil penguraian biasanya berupa hierarki node yang mewakili struktur dokumen. Ini disebut pohon penguraian atau pohon sintaksis.
Misalnya, penguraian ekspresi 2 + 3 - 1 dapat menampilkan hierarki ini:
Tata Bahasa
Penguraian didasarkan pada aturan sintaksis yang dipatuhi dokumen: bahasa atau format penulisannya. Setiap format yang dapat Anda uraikan harus memiliki tata bahasa deterministik yang terdiri dari aturan kosakata dan sintaksis. Ini disebut tata bahasa bebas konteks. Bahasa manusia bukanlah bahasa seperti itu, sehingga tidak dapat diurai dengan teknik penguraian konvensional.
Kombinasi Parser - Lexer
Penguraian dapat dipisahkan menjadi dua subproses: analisis leksikal dan analisis sintaksis.
Analisis leksikal adalah proses memecah input menjadi token. Token adalah kosakata bahasa: kumpulan elemen penyusun yang valid. Dalam bahasa manusia, kosakata akan terdiri dari semua kata yang muncul dalam kamus untuk bahasa tersebut.
Analisis sintaksis adalah penerapan aturan sintaksis bahasa.
Parser biasanya membagi pekerjaan antara dua komponen: lexer (terkadang disebut tokenizer) yang bertanggung jawab untuk memecah input menjadi token yang valid, dan parser yang bertanggung jawab untuk membuat hierarki penguraian dengan menganalisis struktur dokumen sesuai dengan aturan sintaksis bahasa.
Lexer tahu cara menghapus karakter yang tidak relevan seperti spasi kosong dan jeda baris.
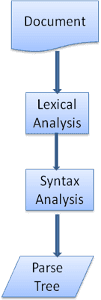
Proses penguraian bersifat iteratif. Parser biasanya akan meminta token baru dari lexer dan mencoba mencocokkan token tersebut dengan salah satu aturan sintaksis. Jika aturan cocok, node yang sesuai dengan token akan ditambahkan ke hierarki penguraian dan parser akan meminta token lain.
Jika tidak ada aturan yang cocok, parser akan menyimpan token secara internal, dan terus meminta token hingga aturan yang cocok dengan semua token yang disimpan secara internal ditemukan. Jika tidak ada aturan yang ditemukan, parser akan memunculkan pengecualian. Artinya, dokumen tersebut tidak valid dan berisi error sintaksis.
Terjemahan
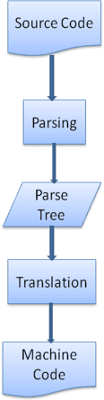
Dalam banyak kasus, pohon penguraian bukanlah produk akhir. Penguraian sering digunakan dalam penerjemahan: mengubah dokumen input ke format lain. Contohnya adalah kompilasi. Compiler yang mengompilasi kode sumber menjadi kode mesin akan mengurainya terlebih dahulu menjadi pohon penguraian, lalu menerjemahkan pohon tersebut menjadi dokumen kode mesin.
Contoh penguraian
Pada gambar 5, kita membuat pohon penguraian dari ekspresi matematika. Mari kita coba tentukan bahasa matematika sederhana dan lihat proses penguraiannya.
Sintaksis:
- Elemen penyusun sintaksis bahasa adalah ekspresi, istilah, dan operasi.
- Bahasa kita dapat menyertakan sejumlah ekspresi.
- Ekspresi didefinisikan sebagai "istilah" yang diikuti dengan "operasi" yang diikuti dengan istilah lain
- Operasi adalah token plus atau token minus
- Istilah adalah token bilangan bulat atau ekspresi
Mari kita analisis input 2 + 3 - 1.
Substring pertama yang cocok dengan aturan adalah 2: menurut aturan #5, substring ini adalah istilah.
Kecocokan kedua adalah 2 + 3: ini cocok dengan aturan ketiga: istilah yang diikuti dengan operasi yang diikuti dengan istilah lain.
Kecocokan berikutnya hanya akan ditemukan di akhir input.
2 + 3 - 1 adalah ekspresi karena kita sudah tahu bahwa 2 + 3 adalah istilah, jadi kita memiliki istilah yang diikuti dengan operasi yang diikuti dengan istilah lain.
2 + + tidak akan cocok dengan aturan apa pun sehingga merupakan input yang tidak valid.
Definisi formal untuk kosakata dan sintaksis
Kosakata biasanya dinyatakan dengan ekspresi reguler.
Misalnya, bahasa kita akan didefinisikan sebagai:
INTEGER: 0|[1-9][0-9]*
PLUS: +
MINUS: -
Seperti yang Anda lihat, bilangan bulat ditentukan oleh ekspresi reguler.
Sintaksis biasanya ditentukan dalam format yang disebut BNF. Bahasa kita akan didefinisikan sebagai:
expression :=  term  operation  term
operation :=  PLUS | MINUS
term := INTEGER | expression
Kami mengatakan bahwa suatu bahasa dapat diuraikan oleh parser reguler jika tata bahasanya adalah tata bahasa bebas konteks. Definisi intuitif dari tata bahasa bebas konteks adalah tata bahasa yang dapat sepenuhnya dinyatakan dalam BNF. Untuk definisi formal, lihat artikel Wikipedia tentang Tata bahasa bebas konteks
Jenis parser
Ada dua jenis parser: parser top-down dan parser bottom-up. Penjelasan intuitifnya adalah parser top-down memeriksa struktur tingkat tinggi sintaksis dan mencoba menemukan kecocokan aturan. Parser bottom-up dimulai dengan input dan secara bertahap mengubahnya menjadi aturan sintaksis, mulai dari aturan tingkat rendah hingga aturan tingkat tinggi terpenuhi.
Mari kita lihat cara kedua jenis parser ini mengurai contoh kita.
Parser top down akan memulai dari aturan tingkat yang lebih tinggi: parser akan mengidentifikasi 2 + 3 sebagai ekspresi. Kemudian, parser akan mengidentifikasi 2 + 3 - 1 sebagai ekspresi (proses identifikasi ekspresi berkembang, yang cocok dengan aturan lain, tetapi titik awalnya adalah aturan tingkat tertinggi).
Parser bottom-up akan memindai input hingga aturan cocok. Kemudian, model akan mengganti input yang cocok dengan aturan tersebut. Proses ini akan berlanjut hingga akhir input. Ekspresi yang cocok sebagian ditempatkan di stack parser.
Jenis parser bottom-up ini disebut parser shift-reduce, karena input digeser ke kanan (bayangkan pointer yang pertama-tama menunjuk ke awal input dan bergerak ke kanan) dan secara bertahap direduksi menjadi aturan sintaksis.
Membuat parser secara otomatis
Ada alat yang dapat membuat parser. Anda memberikan tata bahasa Anda - aturan kosakata dan sintaksisnya - dan generator parser akan menghasilkan parser yang berfungsi. Membuat parser memerlukan pemahaman mendalam tentang penguraian dan tidak mudah untuk membuat parser yang dioptimalkan secara manual, sehingga generator parser dapat sangat berguna.
WebKit menggunakan dua generator parser yang terkenal: Flex untuk membuat lexer dan Bison untuk membuat parser (Anda mungkin menemukannya dengan nama Lex dan Yacc). Input Flex adalah file yang berisi definisi ekspresi reguler token. Input Bison adalah aturan sintaksis bahasa dalam format BNF.
Parser HTML
Tugas parser HTML adalah mengurai markup HTML menjadi hierarki penguraian.
Tata bahasa HTML
Kosakata dan sintaksis HTML ditentukan dalam spesifikasi yang dibuat oleh organisasi W3C.
Seperti yang telah kita lihat dalam pengantar penguraian, sintaksis tata bahasa dapat ditentukan secara formal menggunakan format seperti BNF.
Sayangnya, semua topik parser konvensional tidak berlaku untuk HTML (kami tidak membahasnya hanya untuk bersenang-senang - topik tersebut akan digunakan dalam penguraian CSS dan JavaScript). HTML tidak dapat dengan mudah didefinisikan oleh tata bahasa bebas konteks yang diperlukan parser.
Ada format formal untuk menentukan HTML - DTD (Document Type Definition) - tetapi ini bukan tata bahasa bebas konteks.
Hal ini tampak aneh pada pandangan pertama; HTML agak mirip dengan XML. Ada banyak parser XML yang tersedia. Ada variasi XML dari HTML - XHTML - jadi apa perbedaan besarnya?
Perbedaannya adalah pendekatan HTML lebih "fleksibel": pendekatan ini memungkinkan Anda menghilangkan tag tertentu (yang kemudian ditambahkan secara implisit), atau terkadang menghilangkan tag awal atau akhir, dan sebagainya. Secara keseluruhan, sintaksisnya "fleksibel", berbeda dengan sintaksis XML yang kaku dan menuntut.
Detail yang tampaknya kecil ini membuat perbedaan yang besar. Di satu sisi, inilah alasan utama mengapa HTML sangat populer: HTML memaafkan kesalahan Anda dan memudahkan kehidupan penulis web. Di sisi lain, hal ini menyulitkan penulisan tata bahasa formal. Jadi, singkatnya, HTML tidak dapat diurai dengan mudah oleh parser konvensional, karena tata bahasanya tidak bebas konteks. HTML tidak dapat diuraikan oleh parser XML.
DTD HTML
Definisi HTML dalam format DTD. Format ini digunakan untuk menentukan bahasa dari kelompok SGML. Format ini berisi definisi untuk semua elemen yang diizinkan, atributnya, dan hierarkinya. Seperti yang kita lihat sebelumnya, DTD HTML tidak membentuk tata bahasa bebas konteks.
Ada beberapa variasi DTD. Mode ketat hanya sesuai dengan spesifikasi, tetapi mode lainnya berisi dukungan untuk markup yang digunakan oleh browser pada masa lalu. Tujuannya adalah kompatibilitas mundur dengan konten lama. DTD ketat saat ini ada di sini: www.w3.org/TR/html4/strict.dtd
DOM
Hierarki output ("hierarki penguraian") adalah hierarki node elemen dan atribut DOM. DOM adalah singkatan dari Document Object Model. DOM adalah representasi objek dari dokumen HTML dan antarmuka elemen HTML ke dunia luar seperti JavaScript.
Root hierarki adalah objek "Document".
DOM memiliki hubungan yang hampir satu-ke-satu dengan markup. Contoh:
<html>
  <body>
    <p>
      Hello World
    </p>
    <div> <img src="example.png"/></div>
  </body>
</html>
Markup ini akan diterjemahkan ke hierarki DOM berikut:
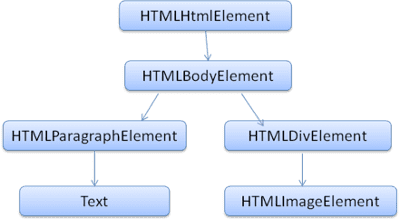
Seperti HTML, DOM ditentukan oleh organisasi W3C. Lihat www.w3.org/DOM/DOMTR. Ini adalah spesifikasi umum untuk memanipulasi dokumen. Modul tertentu menjelaskan elemen spesifik HTML. Definisi HTML dapat ditemukan di sini: www.w3.org/TR/2003/REC-DOM-Level-2-HTML-20030109/idl-definitions.html.
Saat saya mengatakan hierarki berisi node DOM, maksud saya hierarki tersebut dibuat dari elemen yang mengimplementasikan salah satu antarmuka DOM. Browser menggunakan implementasi konkret yang memiliki atribut lain yang digunakan oleh browser secara internal.
Algoritma penguraian
Seperti yang kita lihat di bagian sebelumnya, HTML tidak dapat diuraikan menggunakan parser top-down atau bottom-up biasa.
Alasannya adalah:
- Sifat bahasa yang fleksibel.
- Fakta bahwa browser memiliki toleransi error tradisional untuk mendukung kasus HTML yang tidak valid yang umum terjadi.
- Proses penguraian bersifat reentrant. Untuk bahasa lain, sumbernya tidak berubah selama penguraian, tetapi dalam HTML, kode dinamis (seperti elemen skrip yang berisi panggilan
document.write()) dapat menambahkan token tambahan, sehingga proses penguraian benar-benar mengubah input.
Karena tidak dapat menggunakan teknik penguraian reguler, browser membuat parser kustom untuk mengurai HTML.
Algoritma penguraian dijelaskan secara mendetail dalam spesifikasi HTML5. Algoritmanya terdiri dari dua tahap: tokenisasi dan konstruksi hierarki.
Tokenisasi adalah analisis leksikal, yang mengurai input menjadi token. Token HTML mencakup tag awal, tag akhir, nama atribut, dan nilai atribut.
Tokenizer mengenali token, memberikannya ke konstruktor hierarki, dan menggunakan karakter berikutnya untuk mengenali token berikutnya, dan seterusnya hingga akhir input.
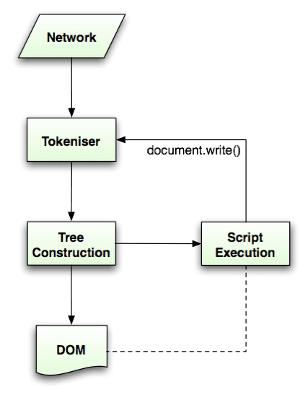
Algoritma tokenisasi
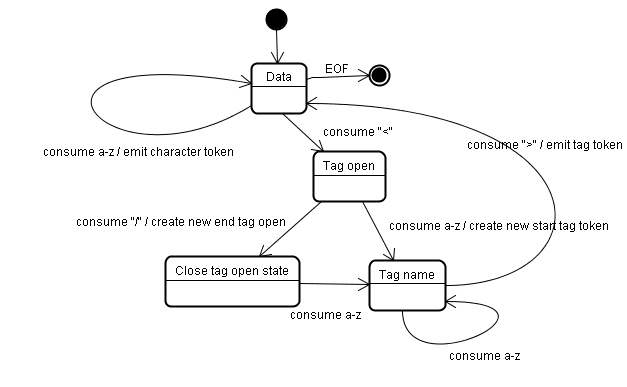
Output algoritma adalah token HTML. Algoritma ini dinyatakan sebagai mesin status. Setiap status menggunakan satu atau beberapa karakter aliran input dan memperbarui status berikutnya sesuai dengan karakter tersebut. Keputusan ini dipengaruhi oleh status tokenisasi saat ini dan status konstruksi hierarki. Artinya, karakter yang sama yang digunakan akan menghasilkan hasil yang berbeda untuk status berikutnya yang benar, bergantung pada status saat ini. Algoritmanya terlalu rumit untuk dijelaskan sepenuhnya, jadi mari kita lihat contoh sederhana yang akan membantu kita memahami prinsipnya.
Contoh dasar - mentokenisasi HTML berikut:
<html>
  <body>
    Hello world
  </body>
</html>
Status awal adalah "Status data".
Saat karakter < ditemukan, status akan diubah menjadi "Tag open state".
Menggunakan karakter a-z akan menyebabkan pembuatan "Token tag awal", statusnya diubah menjadi "Status nama tag".
Kita tetap dalam status ini hingga karakter > digunakan. Setiap karakter ditambahkan ke nama token baru. Dalam kasus ini, token yang dibuat adalah token html.
Saat tag > tercapai, token saat ini akan ditampilkan dan statusnya akan berubah kembali ke "Status data".
Tag <body> akan diperlakukan dengan langkah-langkah yang sama.
Sejauh ini, tag html dan body telah ditampilkan. Sekarang kita kembali ke "Status data".
Menggunakan karakter H dari Hello world akan menyebabkan pembuatan dan pengiriman token karakter, hal ini akan terus berlanjut hingga < dari </body> tercapai. Kami akan memunculkan token karakter untuk setiap karakter Hello world.
Sekarang kita kembali ke "Tag open state".
Menggunakan input / berikutnya akan menyebabkan pembuatan end tag token dan perpindahan ke "Status nama tag". Sekali lagi, kita tetap dalam status ini hingga mencapai >.Kemudian, token tag baru akan ditampilkan dan kita kembali ke "Status data".
Input </html> akan diperlakukan seperti kasus sebelumnya.
Algoritma konstruksi hierarki
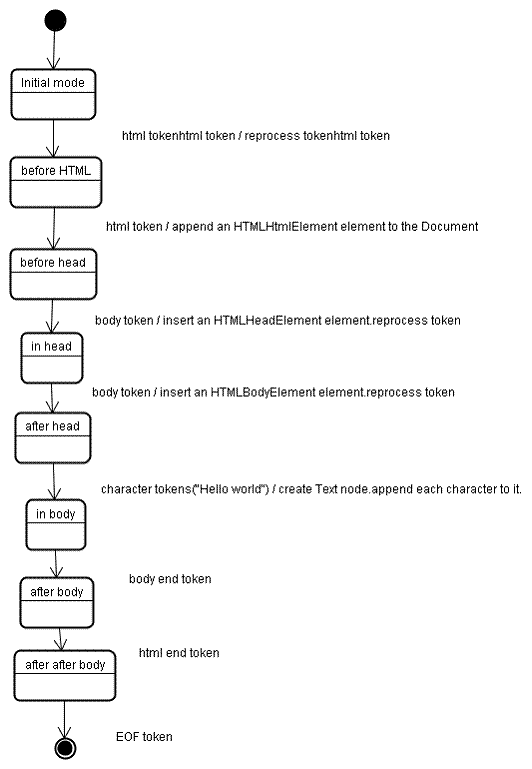
Saat parser dibuat, objek Document juga dibuat. Selama tahap konstruksi hierarki, hierarki DOM dengan Dokumen di root-nya akan diubah dan elemen akan ditambahkan ke dalamnya. Setiap node yang dikeluarkan oleh tokenizer akan diproses oleh konstruktor hierarki. Untuk setiap token, spesifikasi menentukan elemen DOM mana yang relevan dan akan dibuat untuk token ini. Elemen ditambahkan ke hierarki DOM, dan juga stack elemen terbuka. Stack ini digunakan untuk memperbaiki ketidakcocokan bertingkat dan tag yang belum ditutup. Algoritma ini juga dijelaskan sebagai mesin status. Status ini disebut "mode penyisipan".
Mari kita lihat proses pembuatan hierarki untuk contoh input:
<html>
  <body>
    Hello world
  </body>
</html>
Input ke tahap konstruksi hierarki adalah urutan token dari tahap tokenisasi. Mode pertama adalah "mode awal". Menerima token "html" akan menyebabkan perpindahan ke mode "before html" dan pemrosesan ulang token dalam mode tersebut. Tindakan ini akan menyebabkan pembuatan elemen HTMLHtmlElement, yang akan ditambahkan ke objek Document root.
Status akan diubah menjadi "before head". Token "body" kemudian diterima. HTMLHeadElement akan dibuat secara implisit meskipun kita tidak memiliki token "head" dan akan ditambahkan ke hierarki.
Sekarang kita beralih ke mode "in head", lalu ke "after head". Token isi diproses ulang, HTMLBodyElement dibuat dan disisipkan, dan mode ditransfer ke "in body".
Token karakter string "Halo dunia" kini diterima. Karakter pertama akan menyebabkan pembuatan dan penyisipan node "Teks" dan karakter lainnya akan ditambahkan ke node tersebut.
Penerimaan token akhir isi akan menyebabkan transfer ke mode "setelah isi". Sekarang kita akan menerima tag akhir html yang akan memindahkan kita ke mode "after after body". Menerima token akhir file akan mengakhiri penguraian.
Tindakan saat penguraian selesai
Pada tahap ini, browser akan menandai dokumen sebagai interaktif dan mulai mengurai skrip yang berada dalam mode "ditangguhkan": skrip yang harus dieksekusi setelah dokumen diurai. Status dokumen kemudian akan ditetapkan ke "complete" dan peristiwa "load" akan diaktifkan.
Anda dapat melihat algoritma lengkap untuk tokenisasi dan konstruksi hierarki dalam spesifikasi HTML5.
Toleransi error browser
Anda tidak akan pernah mendapatkan error "Sintaksis Tidak Valid" di halaman HTML. Browser akan memperbaiki konten yang tidak valid dan melanjutkan prosesnya.
Misalnya, HTML ini:
<html>
  <mytag>
  </mytag>
  <div>
  <p>
  </div>
    Really lousy HTML
  </p>
</html>
Saya pasti telah melanggar sekitar satu juta aturan ("mytag" bukan tag standar, penyusunan bertingkat yang salah untuk elemen "p" dan "div", dan lainnya), tetapi browser tetap menampilkannya dengan benar dan tidak mengeluh. Jadi, banyak kode parser yang memperbaiki kesalahan penulis HTML.
Penanganan error cukup konsisten di browser, tetapi yang mengejutkan, penanganan error belum menjadi bagian dari spesifikasi HTML. Seperti bookmark dan tombol kembali/maju, fitur ini dikembangkan di browser selama bertahun-tahun. Ada konstruksi HTML tidak valid yang diketahui berulang di banyak situs, dan browser mencoba memperbaikinya dengan cara yang sesuai dengan browser lain.
Spesifikasi HTML5 menentukan beberapa persyaratan ini. (WebKit meringkas hal ini dengan baik dalam komentar di awal class parser HTML.)
Parser mengurai input yang ditokenisasi ke dalam dokumen, sehingga membangun hierarki dokumen. Jika dokumen memiliki format yang baik, penguraiannya akan mudah.
Sayangnya, kita harus menangani banyak dokumen HTML yang tidak terbentuk dengan baik, sehingga parser harus toleran terhadap error.
Kita harus menangani setidaknya kondisi error berikut:
- Elemen yang ditambahkan secara eksplisit dilarang di dalam beberapa tag luar. Dalam hal ini, kita harus menutup semua tag hingga tag yang melarang elemen, dan menambahkannya setelahnya.
- Kita tidak diizinkan untuk menambahkan elemen secara langsung. Mungkin saja orang yang menulis dokumen lupa menyertakan beberapa tag di antaranya (atau tag di antaranya bersifat opsional). Hal ini dapat terjadi pada tag berikut: HTML HEAD BODY TBODY TR TD LI (apakah ada yang terlupa?).
- Kita ingin menambahkan elemen blok di dalam elemen inline. Tutup semua elemen inline hingga elemen blok yang lebih tinggi berikutnya.
- Jika cara ini tidak membantu, tutup elemen hingga kita diizinkan untuk menambahkan elemen - atau abaikan tag.
Mari kita lihat beberapa contoh toleransi error WebKit:
</br> bukan <br>
Beberapa situs menggunakan </br>, bukan <br>. Agar kompatibel dengan IE dan Firefox, WebKit memperlakukan ini seperti <br>.
Kode:
if (t->isCloseTag(brTag) && m_document->inCompatMode()) {
     reportError(MalformedBRError);
     t->beginTag = true;
}
Perhatikan bahwa penanganan error bersifat internal: penanganan error tidak akan ditampilkan kepada pengguna.
Tabel yang tidak terpakai
Tabel tersesat adalah tabel di dalam tabel lain, tetapi tidak di dalam sel tabel.
Contoh:
<table>
  <table>
    <tr><td>inner table</td></tr>
  </table>
  <tr><td>outer table</td></tr>
</table>
WebKit akan mengubah hierarki menjadi dua tabel yang setara:
<table>
  <tr><td>outer table</td></tr>
</table>
<table>
  <tr><td>inner table</td></tr>
</table>
Kode:
if (m_inStrayTableContent && localName == tableTag)
        popBlock(tableTag);
WebKit menggunakan stack untuk konten elemen saat ini: WebKit akan mengeluarkan tabel dalam dari stack tabel luar. Tabel sekarang akan menjadi seinduk.
Elemen formulir bertingkat
Jika pengguna menempatkan formulir di dalam formulir lain, formulir kedua akan diabaikan.
Kode:
if (!m_currentFormElement) {
        m_currentFormElement = new HTMLFormElement(formTag,    m_document);
}
Hierarki tag yang terlalu dalam
Komentar tersebut sudah jelas.
bool HTMLParser::allowNestedRedundantTag(const AtomicString& tagName)
{

unsigned i = 0;
for (HTMLStackElem* curr = m_blockStack;
         i < cMaxRedundantTagDepth && curr && curr->tagName == tagName;
     curr = curr->next, i++) { }
return i != cMaxRedundantTagDepth;
}
Tag penutup html atau body salah tempat
Sekali lagi, komentar tersebut sudah jelas.
if (t->tagName == htmlTag || t->tagName == bodyTag )
        return;
Jadi, penulis web harus berhati-hati - kecuali jika Anda ingin muncul sebagai contoh dalam cuplikan kode toleransi error WebKit - tulis HTML yang terbentuk dengan baik.
Penguraian CSS
Ingat konsep penguraian dalam pengantar? Tidak seperti HTML, CSS adalah tata bahasa bebas konteks dan dapat diuraikan menggunakan jenis parser yang dijelaskan dalam pengantar. Bahkan, spesifikasi CSS menentukan tata bahasa leksikal dan sintaksis CSS.
Mari kita lihat beberapa contohnya:
Tata bahasa leksikal (kosakata) ditentukan oleh ekspresi reguler untuk setiap token:
comment   \/\*[^*]*\*+([^/*][^*]*\*+)*\/
num       [0-9]+|[0-9]*"."[0-9]+
nonascii  [\200-\377]
nmstart   [_a-z]|{nonascii}|{escape}
nmchar    [_a-z0-9-]|{nonascii}|{escape}
name      {nmchar}+
ident     {nmstart}{nmchar}*
"ident" adalah singkatan dari ID, seperti nama class. "name" adalah ID elemen (yang dirujuk oleh "#" )
Tata bahasa sintaksis dijelaskan dalam BNF.
ruleset
  : selector [ ',' S* selector ]*
    '{' S* declaration [ ';' S* declaration ]* '}' S*
  ;
selector
  : simple_selector [ combinator selector | S+ [ combinator? selector ]? ]?
  ;
simple_selector
  : element_name [ HASH | class | attrib | pseudo ]*
  | [ HASH | class | attrib | pseudo ]+
  ;
class
  : '.' IDENT
  ;
element_name
  : IDENT | '*'
  ;
attrib
  : '[' S* IDENT S* [ [ '=' | INCLUDES | DASHMATCH ] S*
    [ IDENT | STRING ] S* ] ']'
  ;
pseudo
  : ':' [ IDENT | FUNCTION S* [IDENT S*] ')' ]
  ;
Penjelasan:
Ruleset adalah struktur ini:
div.error, a.error {
  color:red;
  font-weight:bold;
}
div.error dan a.error adalah pemilih. Bagian di dalam tanda kurung kurawal berisi aturan yang diterapkan oleh ruleset ini.
Struktur ini didefinisikan secara formal dalam definisi ini:
ruleset
  : selector [ ',' S* selector ]*
    '{' S* declaration [ ';' S* declaration ]* '}' S*
  ;
Artinya, ruleset adalah pemilih atau secara opsional sejumlah pemilih yang dipisahkan oleh koma dan spasi (S adalah singkatan dari spasi kosong). {i>Ruleset<i} berisi tanda kurung kurawal dan di dalamnya terdapat deklarasi atau secara opsional sejumlah deklarasi yang dipisahkan oleh titik koma. "declaration" dan "selector" akan ditentukan dalam definisi BNF berikut.
Parser CSS WebKit
WebKit menggunakan generator parser Flex dan Bison untuk membuat parser secara otomatis dari file tata bahasa CSS. Seperti yang Anda ingat dari pengantar parser, Bison membuat parser shift-reduce bottom-up. Firefox menggunakan parser top down yang ditulis secara manual. Dalam kedua kasus tersebut, setiap file CSS diuraikan menjadi objek StyleSheet. Setiap objek berisi aturan CSS. Objek aturan CSS berisi objek pemilih dan deklarasi serta objek lain yang sesuai dengan tata bahasa CSS.
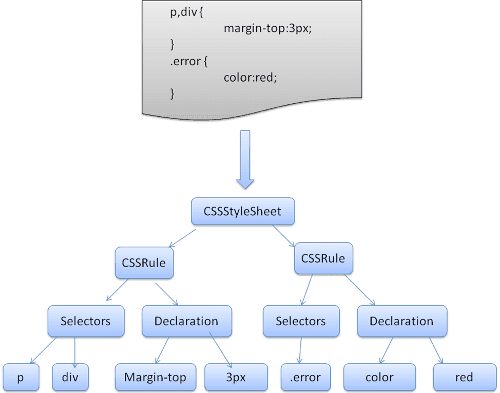
Urutan pemrosesan untuk skrip dan lembar gaya
Skrip
Model web bersifat sinkron. Penulis mengharapkan skrip diurai dan dieksekusi segera setelah parser mencapai tag <script>.
Penguraian dokumen akan berhenti hingga skrip dijalankan.
Jika skrip bersifat eksternal, resource harus diambil terlebih dahulu dari jaringan. Hal ini juga dilakukan secara sinkron, dan penguraian akan berhenti hingga resource diambil.
Model ini telah digunakan selama bertahun-tahun dan juga ditentukan dalam spesifikasi HTML4 dan 5.
Penulis dapat menambahkan atribut "defer" ke skrip, sehingga skrip tidak akan menghentikan penguraian dokumen dan akan dieksekusi setelah dokumen diuraikan. HTML5 menambahkan opsi untuk menandai skrip sebagai asinkron sehingga akan diuraikan dan dieksekusi oleh thread yang berbeda.
Penguraian spekulatif
WebKit dan Firefox melakukan pengoptimalan ini. Saat mengeksekusi skrip, thread lain mengurai bagian dokumen lainnya dan mencari tahu resource lain yang perlu dimuat dari jaringan, lalu memuatnya. Dengan cara ini, resource dapat dimuat pada koneksi paralel dan kecepatan keseluruhan akan meningkat. Catatan: parser spekulatif hanya mengurai referensi ke resource eksternal seperti skrip eksternal, stylesheet, dan gambar: parser ini tidak mengubah hierarki DOM, yang diserahkan kepada parser utama.
Lembar gaya
Di sisi lain, stylesheet memiliki model yang berbeda. Secara konseptual, tampaknya karena stylesheet tidak mengubah hierarki DOM, tidak ada alasan untuk menunggu stylesheet dan menghentikan penguraian dokumen. Namun, ada masalah terkait skrip yang meminta informasi gaya selama tahap penguraian dokumen. Jika gaya belum dimuat dan diuraikan, skrip akan mendapatkan jawaban yang salah dan tampaknya hal ini menyebabkan banyak masalah. Hal ini tampaknya merupakan kasus ekstrem, tetapi cukup umum. Firefox memblokir semua skrip saat ada lembar gaya yang masih dimuat dan diurai. WebKit hanya memblokir skrip saat skrip tersebut mencoba mengakses properti gaya tertentu yang mungkin terpengaruh oleh lembar gaya yang tidak dimuat.
Konstruksi hierarki render
Saat hierarki DOM sedang dibuat, browser membuat hierarki lain, yaitu hierarki render. Hierarki ini berisi elemen visual dalam urutan yang akan ditampilkan. Ini adalah representasi visual dokumen. Tujuan hierarki ini adalah untuk memungkinkan penggambaran konten dalam urutan yang benar.
Firefox menyebut elemen dalam hierarki render sebagai "frame". WebKit menggunakan istilah perender atau objek render.
Perender tahu cara menata letak dan menggambar dirinya sendiri dan turunannya.
Class RenderObject WebKit, class dasar perender, memiliki definisi berikut:
class RenderObject{
  virtual void layout();
  virtual void paint(PaintInfo);
  virtual void rect repaintRect();
  Node* node;  //the DOM node
  RenderStyle* style;  // the computed style
  RenderLayer* containgLayer; //the containing z-index layer
}
Setiap perender mewakili area persegi panjang yang biasanya sesuai dengan kotak CSS node, seperti yang dijelaskan oleh spesifikasi CSS2. Area ini mencakup informasi geometris seperti lebar, tinggi, dan posisi.
Jenis kotak dipengaruhi oleh nilai "display" dari atribut gaya yang relevan dengan node (lihat bagian komputasi gaya). Berikut adalah kode WebKit untuk memutuskan jenis perender yang harus dibuat untuk node DOM, sesuai dengan atribut tampilan:
RenderObject* RenderObject::createObject(Node* node, RenderStyle* style)
{
    Document* doc = node->document();
    RenderArena* arena = doc->renderArena();
    ...
    RenderObject* o = 0;

    switch (style->display()) {
        case NONE:
            break;
        case INLINE:
            o = new (arena) RenderInline(node);
            break;
        case BLOCK:
            o = new (arena) RenderBlock(node);
            break;
        case INLINE_BLOCK:
            o = new (arena) RenderBlock(node);
            break;
        case LIST_ITEM:
            o = new (arena) RenderListItem(node);
            break;
       ...
    }

    return o;
}
Jenis elemen juga dipertimbangkan: misalnya, kontrol formulir dan tabel memiliki frame khusus.
Di WebKit, jika suatu elemen ingin membuat perender khusus, elemen tersebut akan mengganti metode createRenderer().
Perender mengarah ke objek gaya yang berisi informasi non-geometris.
Hubungan hierarki render dengan hierarki DOM
Perender sesuai dengan elemen DOM, tetapi hubungannya tidak satu per satu. Elemen DOM non-visual tidak akan disisipkan dalam hierarki render. Contohnya adalah elemen "head". Elemen yang nilai tampilannya ditetapkan ke "none" juga tidak akan muncul di hierarki (sedangkan elemen dengan visibilitas "hidden" akan muncul di hierarki).
Ada elemen DOM yang sesuai dengan beberapa objek visual. Elemen ini biasanya memiliki struktur kompleks yang tidak dapat dijelaskan dengan satu persegi panjang. Misalnya, elemen "select" memiliki tiga perender: satu untuk area tampilan, satu untuk kotak daftar drop-down, dan satu untuk tombol. Selain itu, jika teks dipecah menjadi beberapa baris karena lebarnya tidak cukup untuk satu baris, baris baru akan ditambahkan sebagai perender tambahan.
Contoh lain dari beberapa perender adalah HTML yang rusak. Menurut spesifikasi CSS, elemen inline hanya boleh berisi elemen blok atau hanya elemen inline. Dalam kasus konten campuran, perender blok anonim akan dibuat untuk menggabungkan elemen inline.
Beberapa objek render sesuai dengan node DOM, tetapi tidak di tempat yang sama dalam hierarki. Elemen float dan yang diposisikan secara absolut berada di luar alur, ditempatkan di bagian hierarki yang berbeda, dan dipetakan ke frame sebenarnya. Frame placeholder adalah tempat yang seharusnya ditempati.
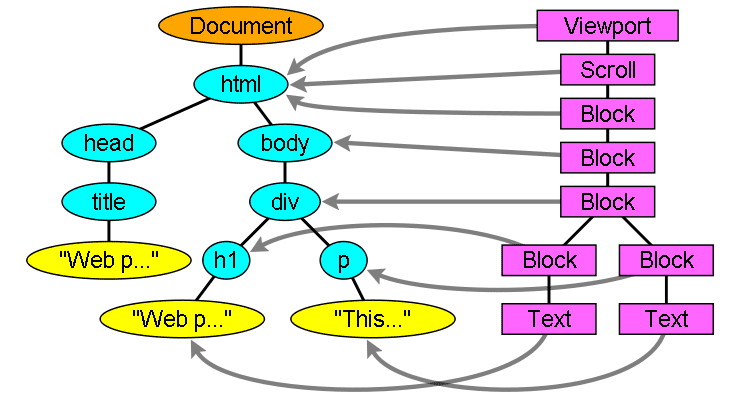
Alur pembuatan pohon
Di Firefox, presentasi didaftarkan sebagai pemroses untuk update DOM.
Presentasi mendelegasikan pembuatan frame ke FrameConstructor dan konstruktor me-resolve gaya (lihat komputasi gaya) dan membuat frame.
Di WebKit, proses penyelesaian gaya dan pembuatan perender disebut "lampiran". Setiap node DOM memiliki metode "attach". Penyisipan bersifat sinkron, penyisipan node ke hierarki DOM memanggil metode "attach" node baru.
Pemrosesan tag html dan body menghasilkan konstruksi root hierarki render.
Objek render root sesuai dengan apa yang disebut spesifikasi CSS sebagai blok penampung: blok paling atas yang berisi semua blok lainnya. Dimensinya adalah area pandang: dimensi area tampilan jendela browser.
Firefox menyebutnya ViewPortFrame dan WebKit menyebutnya RenderView.
Ini adalah objek render yang ditunjuk oleh dokumen.
Bagian hierarki lainnya dibuat sebagai penyisipan node DOM.
Lihat spesifikasi CSS2 tentang model pemrosesan.
Komputasi gaya
Membangun hierarki render memerlukan penghitungan properti visual setiap objek render. Hal ini dilakukan dengan menghitung properti gaya setiap elemen.
Gaya ini mencakup lembar gaya dari berbagai sumber, elemen gaya inline, dan properti visual dalam HTML (seperti properti "bgcolor").Properti visual tersebut diterjemahkan ke properti gaya CSS yang cocok.
Asal lembar gaya adalah lembar gaya default browser, lembar gaya yang disediakan oleh penulis halaman, dan lembar gaya pengguna - ini adalah lembar gaya yang disediakan oleh pengguna browser (browser memungkinkan Anda menentukan gaya favorit Anda. Misalnya, di Firefox, hal ini dilakukan dengan menempatkan lembar gaya di folder "Firefox Profile").
Komputasi gaya menimbulkan beberapa kesulitan:
- Data gaya adalah konstruksi yang sangat besar, yang menyimpan banyak properti gaya, sehingga dapat menyebabkan masalah memori.
Menemukan aturan yang cocok untuk setiap elemen dapat menyebabkan masalah performa jika tidak dioptimalkan. Melakukan penelusuran di seluruh daftar aturan untuk setiap elemen guna menemukan kecocokan adalah tugas yang berat. Pemilih dapat memiliki struktur kompleks yang dapat menyebabkan proses pencocokan dimulai pada jalur yang tampaknya menjanjikan, tetapi terbukti sia-sia dan jalur lain harus dicoba.
Misalnya - pemilih gabungan ini:
div div div div{
...
}
Artinya, aturan berlaku untuk
<div>yang merupakan turunan dari 3 div. Misalnya, Anda ingin memeriksa apakah aturan berlaku untuk elemen<div>tertentu. Anda memilih jalur tertentu di hierarki untuk diperiksa. Anda mungkin perlu melintasi hierarki node ke atas hanya untuk mengetahui bahwa hanya ada dua div dan aturan tidak berlaku. Kemudian, Anda harus mencoba jalur lain di hierarki.Penerapan aturan melibatkan aturan bertingkat yang cukup kompleks yang menentukan hierarki aturan.
Mari kita lihat cara browser menghadapi masalah ini:
Membagikan data gaya
Node WebKit mereferensikan objek gaya (RenderStyle). Objek ini dapat dibagikan oleh node dalam beberapa kondisi. Node adalah saudara kandung atau sepupu dan:
- Elemen harus berada dalam status mouse yang sama (misalnya, satu elemen tidak boleh berada dalam status :hover sementara elemen lainnya tidak)
- Kedua elemen tidak boleh memiliki ID
- Nama tag harus cocok
- Atribut class harus cocok
- Kumpulan atribut yang dipetakan harus identik
- Status link harus cocok
- Status fokus harus cocok
- Kedua elemen tidak boleh terpengaruh oleh pemilih atribut, dengan terpengaruh didefinisikan sebagai memiliki kecocokan pemilih yang menggunakan pemilih atribut di posisi mana pun dalam pemilih
- Tidak boleh ada atribut gaya inline pada elemen
- Tidak boleh ada pemilih seinduk yang digunakan sama sekali. WebCore hanya menampilkan tombol global saat pemilih seinduk ditemukan dan menonaktifkan berbagi gaya untuk seluruh dokumen saat pemilih tersebut ada. Hal ini mencakup pemilih + dan pemilih seperti :first-child dan :last-child.
Pohon aturan Firefox
Firefox memiliki dua hierarki tambahan untuk komputasi gaya yang lebih mudah: hierarki aturan dan hierarki konteks gaya. WebKit juga memiliki objek gaya, tetapi tidak disimpan dalam hierarki seperti hierarki konteks gaya, hanya node DOM yang mengarah ke gaya yang relevan.
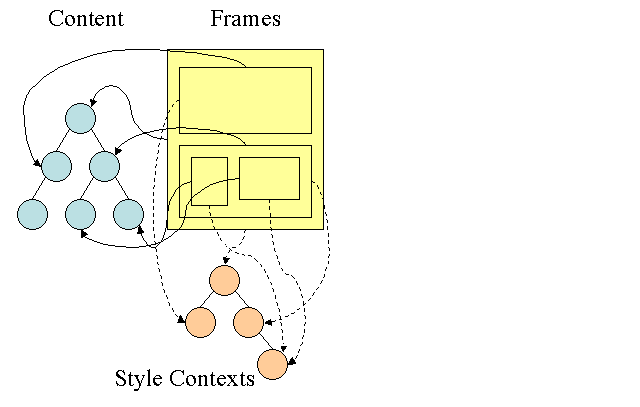
Konteks gaya berisi nilai akhir. Nilai dihitung dengan menerapkan semua aturan yang cocok dalam urutan yang benar dan melakukan manipulasi yang mengubahnya dari nilai logis menjadi nilai konkret. Misalnya, jika nilai logisnya adalah persentase layar, nilai tersebut akan dihitung dan diubah menjadi unit absolut. Ide hierarki aturan ini sangat cerdas. Hal ini memungkinkan pembagian nilai ini di antara node untuk menghindari penghitungan ulang. Tindakan ini juga menghemat ruang.
Semua aturan yang cocok disimpan dalam hierarki. Node bawah dalam jalur memiliki prioritas lebih tinggi. Hierarki berisi semua jalur untuk kecocokan aturan yang ditemukan. Penyimpanan aturan dilakukan secara lambat. Hierarki tidak dihitung di awal untuk setiap node, tetapi setiap kali gaya node perlu dihitung, jalur yang dihitung akan ditambahkan ke hierarki.
Idenya adalah melihat jalur hierarki sebagai kata dalam leksikon. Misalnya, kita telah menghitung hierarki aturan ini:
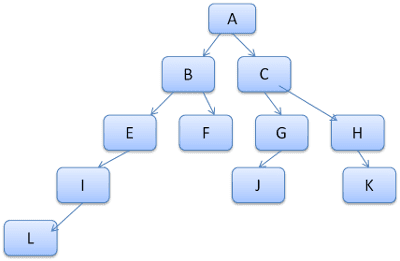
Misalkan kita perlu mencocokkan aturan untuk elemen lain dalam hierarki konten, dan mengetahui aturan yang cocok (dalam urutan yang benar) adalah B-E-I. Kita sudah memiliki jalur ini di hierarki karena kita sudah menghitung jalur A-B-E-I-L. Sekarang kita akan memiliki lebih sedikit pekerjaan yang harus dilakukan.
Mari kita lihat bagaimana hierarki menghemat pekerjaan kita.
Pembagian menjadi struct
Konteks gaya dibagi menjadi struct. Struct tersebut berisi informasi gaya untuk kategori tertentu seperti batas atau warna. Semua properti dalam struct diwariskan atau tidak diwariskan. Properti yang diwarisi adalah properti yang diwarisi dari induknya, kecuali jika ditentukan oleh elemen. Properti yang tidak diwariskan (disebut properti "reset") menggunakan nilai default jika tidak ditentukan.
Hierarki membantu kita dengan meng-cache seluruh struct (yang berisi nilai akhir yang dihitung) dalam hierarki. Idenya adalah jika node bawah tidak menyediakan definisi untuk struct, struct yang di-cache di node atas dapat digunakan.
Menghitung konteks gaya menggunakan hierarki aturan
Saat menghitung konteks gaya untuk elemen tertentu, pertama-tama kita menghitung jalur di hierarki aturan atau menggunakan jalur yang ada. Kemudian, kita mulai menerapkan aturan di jalur untuk mengisi struct dalam konteks gaya baru. Kita mulai dari node bawah jalur - node dengan prioritas tertinggi (biasanya pemilih yang paling spesifik) dan melintasi hierarki hingga struct kita penuh. Jika tidak ada spesifikasi untuk struct di node aturan tersebut, kita dapat melakukan pengoptimalan secara signifikan - kita naik ke atas hierarki hingga menemukan node yang menentukan struct tersebut sepenuhnya dan mengarahkannya - itulah pengoptimalan terbaik - seluruh struct dibagikan. Hal ini menghemat komputasi nilai akhir dan memori.
Jika kami menemukan definisi parsial, kami akan naik ke hierarki hingga struct terisi.
Jika kita tidak menemukan definisi apa pun untuk struct kita, jika struct tersebut adalah jenis "turunan", kita akan mengarah ke struct induk kita di hierarki konteks. Dalam hal ini, kita juga berhasil membagikan struct. Jika struct direset, nilai default akan digunakan.
Jika node yang paling spesifik menambahkan nilai, kita perlu melakukan beberapa penghitungan tambahan untuk mengubahnya menjadi nilai sebenarnya. Kemudian, kami meng-cache hasilnya di node hierarki agar dapat digunakan oleh turunan.
Jika suatu elemen memiliki elemen seinduk yang mengarah ke node hierarki yang sama, seluruh konteks gaya dapat digunakan bersama di antara elemen tersebut.
Mari kita lihat contohnya: Misalnya, kita memiliki HTML ini
<html>
  <body>
    <div class="err" id="div1">
      <p>
        this is a <span class="big"> big error </span>
        this is also a
        <span class="big"> very  big  error</span> error
      </p>
    </div>
    <div class="err" id="div2">another error</div>
  </body>
</html>
Dan aturan berikut:
div {margin: 5px; color:black}
.err {color:red}
.big {margin-top:3px}
div span {margin-bottom:4px}
#div1 {color:blue}
#div2 {color:green}
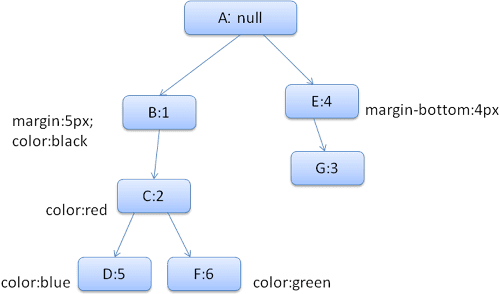
Untuk menyederhanakan, misalnya kita hanya perlu mengisi dua struct: struct warna dan struct margin. Struct warna hanya berisi satu anggota: warna Struct margin berisi empat sisi.
Hierarki aturan yang dihasilkan akan terlihat seperti ini (node ditandai dengan nama node: nomor aturan yang ditunjuk):
Hierarki konteks akan terlihat seperti ini (nama node: node aturan yang ditunjuk):
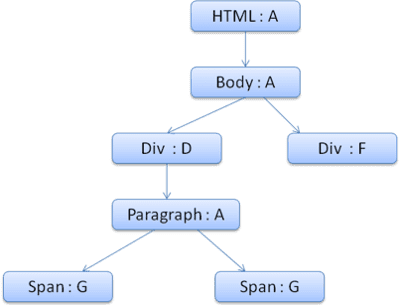
Misalkan kita mengurai HTML dan sampai ke tag <div> kedua. Kita perlu membuat konteks gaya untuk node ini dan mengisi struct gayanya.
Kami akan mencocokkan aturan dan menemukan bahwa aturan yang cocok untuk <div> adalah 1, 2, dan 6.
Artinya, sudah ada jalur yang ada di hierarki yang dapat digunakan elemen kita dan kita hanya perlu menambahkan node lain ke dalamnya untuk aturan 6 (node F di hierarki aturan).
Kita akan membuat konteks gaya dan menempatkannya di hierarki konteks. Konteks gaya baru akan mengarah ke node F di hierarki aturan.
Sekarang kita perlu mengisi struct gaya. Kita akan mulai dengan mengisi struct margin. Karena node aturan terakhir (F) tidak menambahkan ke struct margin, kita dapat naik ke hierarki hingga menemukan struct yang di-cache yang dihitung dalam penyisipan node sebelumnya dan menggunakannya. Kita akan menemukannya di node B, yang merupakan node paling atas yang menentukan aturan margin.
Kita memiliki definisi untuk struct warna, jadi kita tidak dapat menggunakan struct yang di-cache. Karena warna memiliki satu atribut, kita tidak perlu naik ke hierarki untuk mengisi atribut lainnya. Kami akan menghitung nilai akhir (mengonversi string menjadi RGB, dll.) dan meng-cache struct yang dihitung pada node ini.
Pekerjaan pada elemen <span> kedua bahkan lebih mudah. Kita akan mencocokkan aturan dan menyimpulkan bahwa aturan tersebut mengarah ke aturan G, seperti span sebelumnya.
Karena kita memiliki elemen seinduk yang mengarah ke node yang sama, kita dapat membagikan seluruh konteks gaya dan cukup mengarah ke konteks span sebelumnya.
Untuk struct yang berisi aturan yang diwarisi dari induk, caching dilakukan pada hierarki konteks (properti warna sebenarnya diwarisi, tetapi Firefox memperlakukannya sebagai reset dan meng-cache-nya pada hierarki aturan).
Misalnya, jika kita menambahkan aturan untuk font dalam paragraf:
p {font-family: Verdana; font size: 10px; font-weight: bold}
Kemudian, elemen paragraf, yang merupakan turunan dari div di hierarki konteks, dapat berbagi struct font yang sama dengan induknya. Hal ini berlaku jika tidak ada aturan font yang ditentukan untuk paragraf.
Di WebKit, yang tidak memiliki hierarki aturan, deklarasi yang cocok akan dilalui empat kali. Pertama, properti prioritas tinggi yang tidak penting diterapkan (properti yang harus diterapkan terlebih dahulu karena properti lain bergantung padanya, seperti tampilan), lalu properti penting prioritas tinggi, lalu aturan tidak penting prioritas normal, lalu aturan penting prioritas normal. Artinya, properti yang muncul beberapa kali akan di-resolve sesuai dengan urutan menurun yang benar. The last wins.
Jadi, untuk meringkas: membagikan objek gaya (seluruhnya atau beberapa struct di dalamnya) akan menyelesaikan masalah 1 dan 3. Pohon aturan Firefox juga membantu menerapkan properti dalam urutan yang benar.
Memanipulasi aturan agar pertandingan menjadi mudah
Ada beberapa sumber untuk aturan gaya:
- Aturan CSS, baik dalam lembar gaya eksternal maupun dalam elemen gaya.
css p {color: blue} - Atribut gaya inline seperti
html <p style="color: blue" /> - Atribut visual HTML (yang dipetakan ke aturan gaya yang relevan)
html
<p bgcolor="blue" />
Dua yang terakhir mudah dicocokkan dengan elemen karena memiliki atribut gaya dan atribut HTML dapat dipetakan menggunakan elemen sebagai kunci.
Seperti yang disebutkan sebelumnya dalam masalah #2, pencocokan aturan CSS bisa lebih rumit. Untuk mengatasi kesulitan tersebut, aturan dimanipulasi agar lebih mudah diakses.
Setelah mengurai lembar gaya, aturan akan ditambahkan ke salah satu dari beberapa peta hash, sesuai dengan pemilih. Ada peta berdasarkan ID, nama class, nama tag, dan peta umum untuk apa pun yang tidak termasuk dalam kategori tersebut. Jika pemilihnya adalah ID, aturan akan ditambahkan ke peta ID, jika berupa class, aturan akan ditambahkan ke peta class, dll.
Manipulasi ini membuat pencocokan aturan menjadi jauh lebih mudah. Kita tidak perlu melihat setiap deklarasi: kita dapat mengekstrak aturan yang relevan untuk elemen dari peta. Pengoptimalan ini menghilangkan 95% lebih aturan, sehingga aturan tersebut bahkan tidak perlu dipertimbangkan selama proses pencocokan(4.1).
Misalnya, mari kita lihat aturan gaya berikut:
p.error {color: red}
#messageDiv {height: 50px}
div {margin: 5px}
Aturan pertama akan dimasukkan ke dalam peta class. Yang kedua ke peta ID dan yang ketiga ke peta tag.
Untuk fragmen HTML berikut;
<p class="error">an error occurred</p>
<div id=" messageDiv">this is a message</div>
Pertama-tama, kita akan mencoba menemukan aturan untuk elemen p. Peta class akan berisi kunci "error" yang di dalamnya terdapat aturan untuk "p.error". Elemen div akan memiliki aturan yang relevan di peta id (kuncinya adalah id) dan peta tag. Jadi, satu-satunya pekerjaan yang tersisa adalah mencari tahu aturan mana yang diekstrak oleh kunci yang benar-benar cocok.
Misalnya, jika aturan untuk div adalah:
table div {margin: 5px}
Elemen ini akan tetap diekstrak dari peta tag, karena kuncinya adalah pemilih paling kanan, tetapi tidak akan cocok dengan elemen div kita, yang tidak memiliki ancestor tabel.
WebKit dan Firefox melakukan manipulasi ini.
Urutan kaskade lembar gaya
Objek gaya memiliki properti yang sesuai dengan setiap atribut visual (semua atribut CSS, tetapi lebih umum). Jika properti tidak ditentukan oleh aturan yang cocok, beberapa properti dapat diwarisi oleh objek gaya elemen induk. Properti lainnya memiliki nilai default.
Masalah muncul saat ada lebih dari satu definisi. Di sinilah urutan cascade berperan untuk menyelesaikan masalah.
Deklarasi untuk properti gaya dapat muncul di beberapa lembar gaya, dan beberapa kali di dalam lembar gaya. Artinya, urutan penerapan aturan sangatlah penting. Urutan ini disebut urutan "cascade". Menurut spesifikasi CSS2, urutan kaskade adalah (dari rendah ke tinggi):
- Deklarasi browser
- Pernyataan normal pengguna
- Menulis deklarasi normal
- Membuat pernyataan penting
- Pernyataan penting pengguna
Deklarasi browser adalah yang paling tidak penting dan pengguna mengganti penulis hanya jika deklarasi ditandai sebagai penting. Deklarasi dengan urutan yang sama akan diurutkan berdasarkan kekhususan, lalu urutan penentuannya. Atribut visual HTML diterjemahkan ke deklarasi CSS yang cocok . Aturan ini diperlakukan sebagai aturan penulis dengan prioritas rendah.
Kekhususan
Kekhususan pemilih ditentukan oleh spesifikasi CSS2 sebagai berikut:
- hitung 1 jika deklarasi berasal dari atribut 'style', bukan aturan dengan pemilih, dan 0 jika sebaliknya (= a)
- menghitung jumlah atribut ID dalam pemilih (= b)
- menghitung jumlah atribut dan pseudo-class lainnya dalam pemilih (= c)
- menghitung jumlah nama elemen dan pseudo-elemen dalam pemilih (= d)
Menggabungkan empat angka a-b-c-d (dalam sistem angka dengan basis besar) memberikan kekhususan.
Basis angka yang perlu Anda gunakan ditentukan oleh jumlah tertinggi yang Anda miliki di salah satu kategori.
Misalnya, jika a=14, Anda dapat menggunakan basis heksadesimal. Jika a=17, Anda akan memerlukan basis angka 17 digit. Situasi yang terakhir dapat terjadi dengan pemilih seperti ini: html body div div p… (17 tag di pemilih Anda… sangat tidak mungkin).
Beberapa contohnya:
 *             {}  /* a=0 b=0 c=0 d=0 -> specificity = 0,0,0,0 */
 li            {}  /* a=0 b=0 c=0 d=1 -> specificity = 0,0,0,1 */
 li:first-line {}  /* a=0 b=0 c=0 d=2 -> specificity = 0,0,0,2 */
 ul li         {}  /* a=0 b=0 c=0 d=2 -> specificity = 0,0,0,2 */
 ul ol+li      {}  /* a=0 b=0 c=0 d=3 -> specificity = 0,0,0,3 */
 h1 + *[rel=up]{}  /* a=0 b=0 c=1 d=1 -> specificity = 0,0,1,1 */
 ul ol li.red  {}  /* a=0 b=0 c=1 d=3 -> specificity = 0,0,1,3 */
 li.red.level  {}  /* a=0 b=0 c=2 d=1 -> specificity = 0,0,2,1 */
 #x34y         {}  /* a=0 b=1 c=0 d=0 -> specificity = 0,1,0,0 */
 style=""          /* a=1 b=0 c=0 d=0 -> specificity = 1,0,0,0 */
Mengurutkan aturan
Setelah aturan dicocokkan, aturan tersebut akan diurutkan sesuai dengan aturan menurun.
WebKit menggunakan pengurutan gelembung untuk daftar kecil dan pengurutan gabungan untuk daftar besar.
WebKit menerapkan pengurutan dengan mengganti operator > untuk aturan:
static bool operator >(CSSRuleData& r1, CSSRuleData& r2)
{
    int spec1 = r1.selector()->specificity();
    int spec2 = r2.selector()->specificity();
    return (spec1 == spec2) ? r1.position() > r2.position() : spec1 > spec2;
}
Proses bertahap
WebKit menggunakan flag yang menandai apakah semua stylesheet tingkat atas (termasuk @import) telah dimuat. Jika gaya tidak dimuat sepenuhnya saat dilampirkan, placeholder akan digunakan dan ditandai dalam dokumen, dan akan dihitung ulang setelah sheet gaya dimuat.
Tata Letak
Saat dibuat dan ditambahkan ke hierarki, perender tidak memiliki posisi dan ukuran. Penghitungan nilai ini disebut tata letak atau penataan ulang.
HTML menggunakan model tata letak berbasis alur, yang berarti bahwa sebagian besar waktu, geometri dapat dihitung dalam satu penerusan. Elemen yang muncul kemudian "dalam alur" biasanya tidak memengaruhi geometri elemen yang muncul lebih awal "dalam alur", sehingga tata letak dapat dilanjutkan dari kiri ke kanan, dari atas ke bawah di seluruh dokumen. Ada pengecualian: misalnya, tabel HTML mungkin memerlukan lebih dari satu penerusan.
Sistem koordinat relatif terhadap frame root. Koordinat atas dan kiri digunakan.
Tata letak adalah proses rekursif. Proses ini dimulai di perender root, yang sesuai dengan elemen <html> dokumen HTML. Tata letak berlanjut secara berulang melalui beberapa atau semua hierarki frame, menghitung informasi geometris untuk setiap perender yang memerlukannya.
Posisi perender root adalah 0,0 dan dimensinya adalah area pandang - bagian yang terlihat dari jendela browser.
Semua perender memiliki metode "tata letak" atau "penataan ulang", setiap perender memanggil metode tata letak turunannya yang memerlukan tata letak.
Sistem bit kotor
Agar tidak melakukan tata letak penuh untuk setiap perubahan kecil, browser menggunakan sistem "dirty bit". Perender yang diubah atau ditambahkan akan menandai dirinya sendiri dan turunannya sebagai "dirty": memerlukan tata letak.
Ada dua tanda: "dirty", dan "children are dirty" yang berarti bahwa meskipun perender itu sendiri mungkin OK, perender tersebut memiliki setidaknya satu turunan yang memerlukan tata letak.
Tata letak global dan inkremental
Tata letak dapat dipicu di seluruh hierarki render - ini adalah tata letak "global". Hal ini dapat terjadi akibat:
- Perubahan gaya global yang memengaruhi semua perender, seperti perubahan ukuran font.
- Sebagai hasil dari pengubahan ukuran layar
Tata letak dapat bersifat inkremental, hanya perender yang kotor yang akan ditata letak (hal ini dapat menyebabkan beberapa kerusakan yang memerlukan tata letak tambahan).
Tata letak inkremental dipicu (secara asinkron) saat perender kotor. Misalnya, saat perender baru ditambahkan ke hierarki render setelah konten tambahan berasal dari jaringan dan ditambahkan ke hierarki DOM.
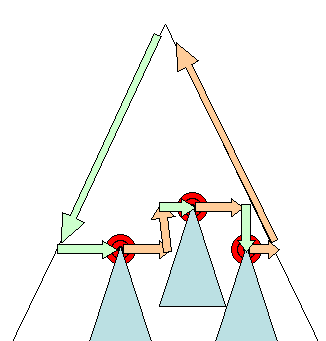
Tata letak asinkron dan sinkron
Tata letak inkremental dilakukan secara asinkron. Firefox mengantrekan "perintah penataan ulang" untuk tata letak inkremental dan penjadwal memicu eksekusi batch perintah ini. WebKit juga memiliki timer yang menjalankan tata letak inkremental - hierarki dilintasi dan perender "dirty" ditata letak.
Skrip yang meminta informasi gaya, seperti "offsetHeight" dapat memicu tata letak inkremental secara sinkron.
Tata letak global biasanya akan dipicu secara sinkron.
Terkadang tata letak dipicu sebagai callback setelah tata letak awal karena beberapa atribut, seperti posisi scroll, berubah.
Pengoptimalan
Saat tata letak dipicu oleh "pengubahan ukuran" atau perubahan posisi perender(bukan ukuran), ukuran render diambil dari cache dan tidak dihitung ulang…
Dalam beberapa kasus, hanya sub-pohon yang diubah dan tata letak tidak dimulai dari root. Hal ini dapat terjadi jika perubahannya bersifat lokal dan tidak memengaruhi sekitarnya - seperti teks yang disisipkan ke dalam kolom teks (jika tidak, setiap penekanan tombol akan memicu tata letak yang dimulai dari root).
Proses tata letak
Tata letak biasanya memiliki pola berikut:
- Perender induk menentukan lebarnya sendiri.
- Orang tua membahas anak-anak dan:
- Tempatkan perender turunan (menetapkan x dan y-nya).
- Memanggil tata letak turunan jika diperlukan - tata letak tersebut kotor atau kita berada dalam tata letak global, atau karena alasan lain - yang menghitung tinggi turunan.
- Induk menggunakan tinggi akumulatif turunan serta tinggi margin dan padding untuk menetapkan tingginya sendiri - ini akan digunakan oleh induk perender induk.
- Menetapkan bit kotornya ke salah (false).
Firefox menggunakan objek "state" (nsHTMLReflowState) sebagai parameter untuk tata letak (disebut "reflow"). Di antaranya, status menyertakan lebar induk.
Output tata letak Firefox adalah objek "metrik" (nsHTMLReflowMetrics). Properti ini akan berisi tinggi yang dihitung perender.
Penghitungan lebar
Lebar perender dihitung menggunakan lebar blok penampung, properti "width" gaya perender, margin, dan batas.
Misalnya, lebar div berikut:
<div style="width: 30%"/>
Akan dihitung oleh WebKit sebagai berikut(metode calcWidth class RenderBox):
- Lebar penampung adalah nilai maksimum dari availableWidth penampung dan 0. availableWidth dalam hal ini adalah contentWidth yang dihitung sebagai:
clientWidth() - paddingLeft() - paddingRight()
clientWidth dan clientHeight mewakili bagian dalam objek, tidak termasuk batas dan scrollbar.
Lebar elemen adalah atribut gaya "width". Nilai ini akan dihitung sebagai nilai absolut dengan menghitung persentase lebar penampung.
Batas horizontal dan padding kini telah ditambahkan.
Sejauh ini, ini adalah penghitungan "lebar yang diinginkan". Sekarang lebar minimum dan maksimum akan dihitung.
Jika lebar yang diinginkan lebih besar dari lebar maksimum, lebar maksimum akan digunakan. Jika lebih kecil dari lebar minimum (unit terkecil yang tidak dapat dipecah), lebar minimum akan digunakan.
Nilai di-cache jika tata letak diperlukan, tetapi lebarnya tidak berubah.
Pemisahan baris
Saat perender di tengah tata letak memutuskan bahwa perender perlu dihentikan, perender akan berhenti dan menyebarkan ke induk tata letak bahwa perender perlu dihentikan. Induk membuat perender tambahan dan memanggil tata letak di dalamnya.
Melukis
Pada tahap penggambaran, hierarki render dilintasi dan metode "paint()" perender dipanggil untuk menampilkan konten di layar. Pengecatan menggunakan komponen infrastruktur UI.
Global dan inkremental
Seperti tata letak, penggambaran juga dapat bersifat global - seluruh hierarki digambar - atau inkremental. Dalam rendering inkremental, beberapa perender berubah dengan cara yang tidak memengaruhi seluruh hierarki. Perender yang diubah membatalkan persegi panjangnya di layar. Hal ini menyebabkan OS melihatnya sebagai "dirty region" dan menghasilkan peristiwa "paint". OS melakukannya dengan cerdas dan menggabungkan beberapa region menjadi satu. Di Chrome, prosesnya lebih rumit karena perender berada dalam proses yang berbeda dengan proses utama. Chrome menyimulasikan perilaku OS sampai batas tertentu. Presentasi memproses peristiwa ini dan mendelegasikan pesan ke root render. Hierarki dilalui hingga perender yang relevan tercapai. Widget ini akan menggambar ulang dirinya sendiri (dan biasanya turunannya).
Urutan pengecatan
CSS2 menentukan urutan proses rendering. Ini sebenarnya adalah urutan penumpukan elemen dalam konteks penumpukan. Urutan ini memengaruhi penggambaran karena tumpukan digambar dari belakang ke depan. Urutan tumpukan perender blok adalah:
- warna latar belakang
- gambar latar
- border
- turunan
- outline
Daftar tampilan Firefox
Firefox memeriksa hierarki render dan membuat daftar tampilan untuk persegi panjang yang digambar. Berisi perender yang relevan untuk persegi panjang, dalam urutan penggambaran yang tepat (latar belakang perender, lalu batas, dll.).
Dengan begitu, hierarki hanya perlu dilalui sekali untuk menggambar ulang, bukan beberapa kali - menggambar semua latar belakang, lalu semua gambar, lalu semua batas, dll.
Firefox mengoptimalkan proses dengan tidak menambahkan elemen yang akan disembunyikan, seperti elemen yang sepenuhnya berada di bawah elemen buram lainnya.
Penyimpanan persegi panjang WebKit
Sebelum menggambar ulang, WebKit menyimpan persegi panjang lama sebagai bitmap. Kemudian, hanya menggambar delta antara persegi panjang baru dan lama.
Perubahan dinamis
Browser mencoba melakukan tindakan seminimal mungkin sebagai respons terhadap perubahan. Jadi, perubahan pada warna elemen hanya akan menyebabkan pengecatan ulang elemen. Perubahan pada posisi elemen akan menyebabkan tata letak dan penggambaran ulang elemen, turunannya, dan mungkin elemen seinduknya. Menambahkan node DOM akan menyebabkan tata letak dan penggambaran ulang node. Perubahan besar, seperti meningkatkan ukuran font elemen "html", akan menyebabkan pembatalan cache, tata letak ulang, dan penggambaran ulang seluruh hierarki.
Thread mesin rendering
Mesin rendering menggunakan single thread. Hampir semuanya, kecuali operasi jaringan, terjadi dalam satu thread. Di Firefox dan Safari, thread ini adalah thread utama browser. Di Chrome, thread ini adalah thread utama proses tab.
Operasi jaringan dapat dilakukan oleh beberapa thread paralel. Jumlah koneksi paralel dibatasi (biasanya 2 - 6 koneksi).
Loop peristiwa
Thread utama browser adalah loop peristiwa. Ini adalah loop tak terbatas yang membuat proses tetap berjalan. Thread ini menunggu peristiwa (seperti peristiwa tata letak dan gambar) dan memprosesnya. Berikut adalah kode Firefox untuk loop peristiwa utama:
while (!mExiting)
    NS_ProcessNextEvent(thread);
Model visual CSS2
Kanvas
Menurut spesifikasi CSS2, istilah kanvas menjelaskan "ruang tempat struktur pemformatan dirender": tempat browser menggambar konten.
Kanvas tidak terbatas untuk setiap dimensi ruang, tetapi browser memilih lebar awal berdasarkan dimensi area pandang.
Menurut www.w3.org/TR/CSS2/zindex.html, kanvas bersifat transparan jika berada di dalam kanvas lain, dan diberi warna yang ditentukan browser jika tidak.
Model kotak CSS
Model kotak CSS menjelaskan kotak persegi panjang yang dihasilkan untuk elemen dalam hierarki dokumen dan ditata sesuai dengan model pemformatan visual.
Setiap kotak memiliki area konten (misalnya, teks, gambar, dll.) serta area padding, batas, dan margin opsional di sekelilingnya.
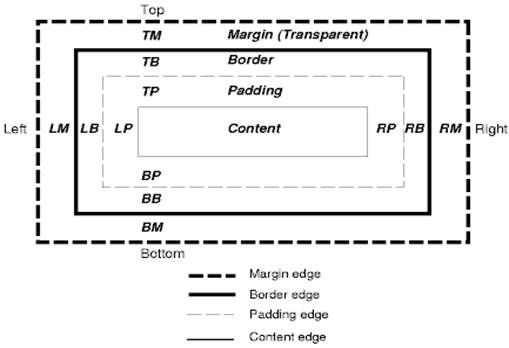
Setiap node menghasilkan 0…n kotak tersebut.
Semua elemen memiliki properti "display" yang menentukan jenis kotak yang akan dibuat.
Contoh:
block: generates a block box.
inline: generates one or more inline boxes.
none: no box is generated.
Defaultnya adalah inline, tetapi lembar gaya browser dapat menetapkan default lainnya. Misalnya: tampilan default untuk elemen "div" adalah blok.
Anda dapat menemukan contoh style sheet default di sini: www.w3.org/TR/CSS2/sample.html.
Skema positioning
Ada tiga skema:
- Normal: objek diposisikan sesuai dengan tempatnya dalam dokumen. Artinya, posisinya di hierarki render sama seperti posisinya di hierarki DOM dan ditata sesuai dengan jenis dan dimensi kotaknya
- Float: objek pertama-tama diletakkan seperti alur normal, lalu dipindahkan sejauh mungkin ke kiri atau kanan
- Absolute: objek ditempatkan di hierarki render di tempat yang berbeda dengan di hierarki DOM
Skema pemosisian ditetapkan oleh properti "position" dan atribut "float".
- static dan relative menyebabkan alur normal
- absolute dan fixed menyebabkan pemosisian absolut
Dalam pemosisian statis, tidak ada posisi yang ditentukan dan pemosisian default digunakan. Dalam skema lain, penulis menentukan posisi: atas, bawah, kiri, kanan.
Cara kotak ditata ditentukan oleh:
- Jenis kotak
- Dimensi kotak
- Skema positioning
- Informasi eksternal seperti ukuran gambar dan ukuran layar
Jenis box
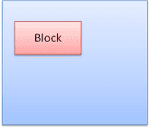
Kotak blok: membentuk blok - memiliki persegi panjangnya sendiri di jendela browser.
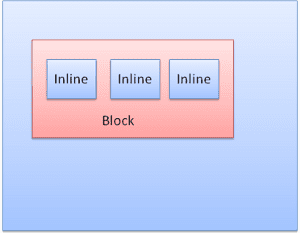
Kotak inline: tidak memiliki bloknya sendiri, tetapi berada di dalam blok penampung.
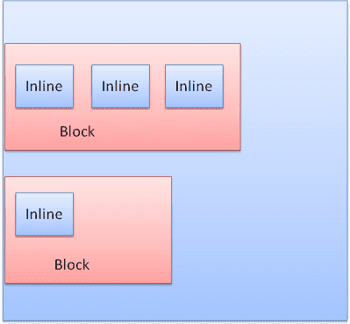
Blok diformat secara vertikal satu per satu. Inline diformat secara horizontal.
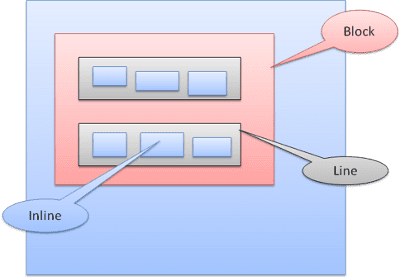
Kotak inline diletakkan di dalam baris atau "kotak baris". Garis setidaknya setinggi kotak tertinggi, tetapi bisa lebih tinggi, jika kotak disejajarkan dengan "baseline" - artinya bagian bawah elemen disejajarkan pada titik kotak lain selain bagian bawah. Jika lebar penampung tidak cukup, inline akan ditempatkan di beberapa baris. Hal ini biasanya terjadi dalam paragraf.
Positioning
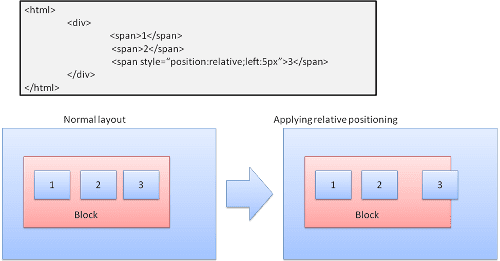
Relatif
Pemosisian relatif - diposisikan seperti biasa, lalu dipindahkan sesuai delta yang diperlukan.
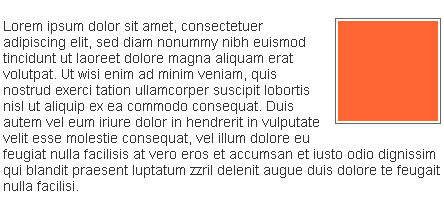
Float
Kotak mengambang digeser ke kiri atau kanan baris. Fitur yang menarik adalah kotak lainnya mengalir di sekitarnya. HTML:
<p>
  <img style="float: right" src="images/image.gif" width="100" height="100">
  Lorem ipsum dolor sit amet, consectetuer...
</p>
Akan terlihat seperti:
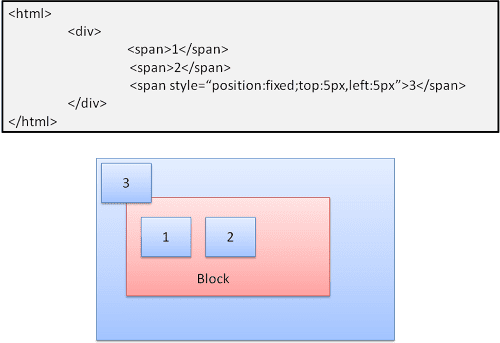
Absolut dan tetap
Tata letak ditentukan secara tepat, terlepas dari alur normal. Elemen tidak berpartisipasi dalam alur normal. Dimensinya relatif terhadap penampung. Dalam posisi tetap, penampungnya adalah area pandang.
Representasi berlapis
Hal ini ditentukan oleh properti CSS z-index. Nilai ini mewakili dimensi ketiga kotak: posisinya di sepanjang "sumbu z".
Kotak-kotak tersebut dibagi menjadi beberapa tumpukan (disebut konteks tumpukan). Di setiap tumpukan, elemen belakang akan digambar terlebih dahulu dan elemen depan di atas, lebih dekat ke pengguna. Jika terjadi tumpang-tindih, elemen terdepan akan menyembunyikan elemen sebelumnya.
Tumpukan diurutkan sesuai dengan properti indeks z. Kotak dengan properti "z-index" membentuk tumpukan lokal. Area pandang memiliki tumpukan luar.
Contoh:
<style type="text/css">
  div {
    position: absolute;
    left: 2in;
    top: 2in;
  }
</style>

<p>
  <div
    style="z-index: 3;background-color:red; width: 1in; height: 1in; ">
  </div>
  <div
    style="z-index: 1;background-color:green;width: 2in; height: 2in;">
  </div>
</p>
Hasilnya akan seperti ini:
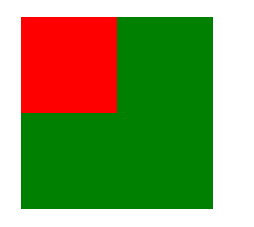
Meskipun div merah mendahului div hijau dalam markup, dan akan digambar sebelumnya dalam alur reguler, properti z-index-nya lebih tinggi, sehingga lebih maju dalam tumpukan yang dipegang oleh kotak root.
Resource
Arsitektur browser
- Grosskurth, Alan. A Reference Architecture for Web Browsers (pdf)
- Gupta, Vineet. Cara Kerja Browser - Bagian 1 - Arsitektur
Penguraian
- Aho, Sethi, Ullman, Compilers: Principles, Techniques, and Tools (alias "Dragon book"), Addison-Wesley, 1986
- Rick Jelliffe. The Bold and the Beautiful: dua draf baru untuk HTML 5.
Firefox
- L. David Baron, Faster HTML and CSS: Layout Engine Internals for Web Developers.
- L. David Baron, Faster HTML and CSS: Layout Engine Internals for Developer Web (video diskusi teknologi Google)
- L. David Baron, Mesin Tata Letak Mozilla
- L. David Baron, Mozilla Style System Documentation
- Chris Waterson, Notes on HTML Reflow
- Chris Waterson, Gecko Overview
- Alexander Larsson, The life of an HTML HTTP request
WebKit
- David Hyatt, Implementing CSS(part 1)
- David Hyatt, An Overview of WebCore
- David Hyatt, Rendering WebCore
- David Hyatt, The FOUC Problem
Spesifikasi W3C
Petunjuk build browser
Terjemahan
Halaman ini telah diterjemahkan ke dalam bahasa Jepang, dua kali:
- Cara Kerja Browser - Di Balik Layar Browser Web Modern (ja) oleh @kosei
- ブラウザってどうやって動いてるの?(モダンWEBブラウザシーンの裏側 oleh @ikeike443 dan @kiyoto01.
Anda dapat melihat terjemahan yang dihosting secara eksternal dalam bahasa Korea dan Turki.
Terima kasih semuanya!