

Bastidores dos navegadores da Web modernos


Prefácio
Este manual abrangente sobre as operações internas do WebKit e do Gecko é o resultado de muita pesquisa feita pelo desenvolvedor israelense Tali Garsiel. Ao longo de alguns anos, ela analisou todos os dados publicados sobre os componentes internos do navegador e passou muito tempo lendo o código-fonte do navegador da Web. Ela escreveu:
Como desenvolvedor Web, aprender os detalhes das operações do navegador ajuda você a tomar decisões melhores e entender as justificativas por trás das práticas recomendadas de desenvolvimento. Embora seja um documento bastante longo, recomendamos que você dedique algum tempo para analisá-lo. Você vai gostar do resultado.
Paul Irish, relações com desenvolvedores do Chrome
Introdução
Os navegadores da Web são os softwares mais usados. Neste guia, explico como
eles funcionam nos bastidores. Vamos ver o que acontece quando você digita google.com
na barra de endereço até que a página do Google apareça na tela do navegador.
Navegadores que vamos abordar
Há cinco navegadores principais usados em computadores hoje: Chrome, Internet Explorer, Firefox, Safari e Opera. Em dispositivos móveis, os principais navegadores são Android Browser, iPhone, Opera Mini e Opera Mobile, UC Browser, os navegadores Nokia S40/S60 e Chrome. Todos eles, exceto os navegadores Opera, são baseados no WebKit. Vou dar exemplos dos navegadores de código aberto Firefox e Chrome, além do Safari (que é parcialmente de código aberto). De acordo com as estatísticas do StatCounter (de junho de 2013), o Chrome, o Firefox e o Safari representam cerca de 71% do uso global de navegadores para computador. Em dispositivos móveis, o navegador Android, o iPhone e o Chrome representam cerca de 54% do uso.
A principal funcionalidade do navegador
A principal função de um navegador é apresentar o recurso da Web que você escolhe, solicitando-o ao servidor e exibindo-o na janela do navegador. O recurso geralmente é um documento HTML, mas também pode ser um PDF, uma imagem ou algum outro tipo de conteúdo. O local do recurso é especificado pelo usuário usando um URI (Uniform Resource Identifier).
A forma como o navegador interpreta e exibe arquivos HTML é especificada nas especificações de HTML e CSS. Essas especificações são mantidas pelo World Wide Web Consortium (W3C), que é a organização de padrões para a Web. Por anos, os navegadores seguiram apenas uma parte das especificações e desenvolveram as próprias extensões. Isso causou sérios problemas de compatibilidade para os autores da Web. Hoje em dia, a maioria dos navegadores segue as especificações.
As interfaces do usuário dos navegadores têm muito em comum. Entre os elementos comuns da interface do usuário estão:
- Barra de endereço para inserir um URI
- Botões "Voltar" e "Avançar"
- Opções de favoritos
- Botões de atualização e parada para atualizar ou interromper o carregamento dos documentos atuais
- Botão "Página inicial" que leva você à sua página inicial
Por incrível que pareça, a interface do usuário do navegador não é especificada em nenhuma especificação formal. Ela é apenas o resultado de boas práticas moldadas ao longo de anos de experiência e de navegadores que se imitam. A especificação do HTML5 não define os elementos da interface que um navegador precisa ter, mas lista alguns elementos comuns. Entre eles estão a barra de endereço, a barra de status e a barra de ferramentas. É claro que existem recursos exclusivos de um navegador específico, como o gerenciador de downloads do Firefox.
Infraestrutura de alto nível
Os principais componentes do navegador são:
- A interface do usuário: inclui a barra de endereço, os botões de voltar/avançar, o menu de favoritos etc. Todas as partes da tela do navegador, exceto a janela em que você vê a página solicitada.
- O mecanismo do navegador: organiza as ações entre a interface e o mecanismo de renderização.
- O mecanismo de renderização: responsável por exibir o conteúdo solicitado. Por exemplo, se o conteúdo solicitado for HTML, o mecanismo de renderização vai analisar o HTML e o CSS e mostrar o conteúdo analisado na tela.
- Rede: para chamadas de rede, como solicitações HTTP, usando implementações diferentes para plataformas diferentes por trás de uma interface independente de plataforma.
- Back-end da interface: usado para desenhar widgets básicos, como caixas de combinação e janelas. Esse back-end expõe uma interface genérica que não é específica da plataforma. Por baixo, ele usa métodos de interface do usuário do sistema operacional.
- Interpretador JavaScript. Usado para analisar e executar código JavaScript.
- Armazenamento de dados. Essa é uma camada de persistência. O navegador pode precisar salvar todos os tipos de dados localmente, como cookies. Os navegadores também são compatíveis com mecanismos de armazenamento, como localStorage, IndexedDB, WebSQL e FileSystem.

É importante observar que navegadores como o Chrome executam várias instâncias do mecanismo de renderização: uma para cada guia. Cada guia é executada em um processo separado.
Mecanismos de renderização
A responsabilidade do mecanismo de renderização é, bem… renderizar, ou seja, exibir o conteúdo solicitado na tela do navegador.
Por padrão, o mecanismo de renderização pode exibir documentos e imagens HTML e XML. Ele pode exibir outros tipos de dados por meio de plug-ins ou extensões, como documentos PDF usando um plug-in de visualização de PDF. No entanto, neste capítulo, vamos nos concentrar no principal caso de uso: exibir HTML e imagens formatadas com CSS.
Navegadores diferentes usam mecanismos de renderização diferentes: o Internet Explorer usa o Trident, o Firefox usa o Gecko e o Safari usa o WebKit. O Chrome e o Opera (da versão 15 em diante) usam o Blink, uma bifurcação do WebKit.
O WebKit é um mecanismo de renderização de código aberto que começou como um mecanismo para a plataforma Linux e foi modificado pela Apple para oferecer suporte ao Mac e ao Windows.
O fluxo principal
O mecanismo de renderização vai começar a receber o conteúdo do documento solicitado da camada de rede. Isso geralmente é feito em blocos de 8 kB.
Depois disso, este é o fluxo básico do mecanismo de renderização:

O mecanismo de renderização vai começar a analisar o documento HTML e converter os elementos em nós do DOM em uma árvore chamada "árvore de conteúdo". O mecanismo vai analisar os dados de estilo, tanto em arquivos CSS externos quanto em elementos de estilo. As informações de estilo, junto com as instruções visuais no HTML, serão usadas para criar outra árvore: a árvore de renderização.
A árvore de renderização contém retângulos com atributos visuais, como cor e dimensões. Os retângulos estão na ordem certa para serem mostrados na tela.
Depois da construção da árvore de renderização, ela passa por um processo de layout. Isso significa dar a cada nó as coordenadas exatas de onde ele deve aparecer na tela. A próxima etapa é a pintura: a árvore de renderização será percorrida, e cada nó será pintado usando a camada de back-end da interface.
É importante entender que esse é um processo gradual. Para melhorar a experiência do usuário, o mecanismo de renderização tenta exibir o conteúdo na tela o mais rápido possível. Ele não espera até que todo o HTML seja analisado para começar a criar e definir o layout da árvore de renderização. Partes do conteúdo serão analisadas e exibidas, enquanto o processo continua com o restante do conteúdo que continua vindo da rede.
Exemplos de fluxo principal


Nas figuras 3 e 4, é possível notar que, embora o WebKit e o Gecko usem uma terminologia um pouco diferente, o fluxo é basicamente o mesmo.
O Gecko chama a árvore de elementos formatados visualmente de "árvore de frames". Cada elemento é um frame. O WebKit usa o termo "árvore de renderização", que consiste em "objetos de renderização". O WebKit usa o termo "layout" para o posicionamento de elementos, enquanto o Gecko o chama de "Reflow". "Anexo" é o termo do WebKit para conectar nós do DOM e informações visuais para criar a árvore de renderização. Uma pequena diferença não semântica é que o Gecko tem uma camada extra entre o HTML e a árvore do DOM. Ele é chamado de "coletor de conteúdo" e é uma fábrica para criar elementos DOM. Vamos falar sobre cada parte do fluxo:
Análise: geral
Como a análise é um processo muito importante no mecanismo de renderização, vamos nos aprofundar um pouco mais nela. Vamos começar com uma breve introdução sobre análise.
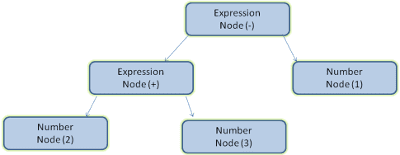
Analisar um documento significa traduzi-lo para uma estrutura que o código possa usar. O resultado da análise geralmente é uma árvore de nós que representa a estrutura do documento. Isso é chamado de árvore de análise ou árvore de sintaxe.
Por exemplo, a análise da expressão 2 + 3 - 1 pode retornar esta árvore:
Gramática
A análise é baseada nas regras de sintaxe que o documento segue: o idioma ou formato em que foi escrito. Cada formato que você pode analisar precisa ter uma gramática determinística que consiste em regras de vocabulário e sintaxe. Isso é chamado de gramática livre de contexto. As linguagens humanas não são assim e, portanto, não podem ser analisadas com técnicas convencionais.
Combinação de analisador e analisador léxico
A análise pode ser dividida em dois subprocessos: análise léxica e análise de sintaxe.
A análise léxica é o processo de dividir a entrada em tokens. Os tokens são o vocabulário da linguagem: a coleção de elementos básicos válidos. Na linguagem humana, ele consiste em todas as palavras que aparecem no dicionário de um idioma.
A análise sintática é a aplicação das regras de sintaxe da linguagem.
Os analisadores geralmente dividem o trabalho entre dois componentes: o analisador léxico (às vezes chamado de tokenizador), que é responsável por dividir a entrada em tokens válidos, e o analisador, que é responsável por construir a árvore de análise analisando a estrutura do documento de acordo com as regras de sintaxe da linguagem.
O analisador léxico sabe como remover caracteres irrelevantes, como espaços em branco e quebras de linha.

O processo de análise é iterativo. O analisador geralmente pede um novo token ao analisador léxico e tenta fazer a correspondência do token com uma das regras de sintaxe. Se uma regra for correspondente, um nó correspondente ao token será adicionado à árvore de análise, e o analisador vai solicitar outro token.
Se nenhuma regra corresponder, o analisador vai armazenar o token internamente e continuar pedindo tokens até encontrar uma regra que corresponda a todos os tokens armazenados internamente. Se nenhuma regra for encontrada, o analisador vai gerar uma exceção. Isso significa que o documento não era válido e continha erros de sintaxe.
Tradução
Em muitos casos, a árvore de análise não é o produto final. A análise sintática é frequentemente usada na tradução: transformar o documento de entrada em outro formato. Um exemplo é a compilação. O compilador que compila o código-fonte em código de máquina primeiro o analisa em uma árvore de análise e, em seguida, traduz a árvore em um documento de código de máquina.

Exemplo de análise
Na figura 5, criamos uma árvore de análise com base em uma expressão matemática. Vamos tentar definir uma linguagem matemática simples e ver o processo de análise.
Sintaxe:
- Os elementos básicos da sintaxe da linguagem são expressões, termos e operações.
- Nossa linguagem pode incluir qualquer número de expressões.
- Uma expressão é definida como um "termo" seguido por uma "operação" seguida por outro termo.
- Uma operação é um token de adição ou subtração.
- Um termo é um token inteiro ou uma expressão
Vamos analisar a entrada 2 + 3 - 1.
A primeira substring que corresponde a uma regra é 2: de acordo com a regra nº 5, é um termo.
A segunda correspondência é 2 + 3: ela corresponde à terceira regra, que é um termo seguido por uma operação seguida por outro termo.
A próxima correspondência só será encontrada no final da entrada.
2 + 3 - 1 é uma expressão porque já sabemos que 2 + 3 é um termo. Portanto, temos um termo seguido por uma operação seguida por outro termo.
2 + + não corresponde a nenhuma regra e, portanto, é uma entrada inválida.
Definições formais de vocabulário e sintaxe
O vocabulário geralmente é expresso por expressões regulares.
Por exemplo, nossa linguagem será definida como:
INTEGER: 0|[1-9][0-9]*
PLUS: +
MINUS: -
Como você pode ver, os números inteiros são definidos por uma expressão regular.
A sintaxe geralmente é definida em um formato chamado BNF. Nossa linguagem será definida como:
expression :=  term  operation  term
operation :=  PLUS | MINUS
term := INTEGER | expression
Dissemos que uma linguagem pode ser analisada por analisadores regulares se a gramática dela for uma gramática livre de contexto. Uma definição intuitiva de uma gramática livre de contexto é uma gramática que pode ser totalmente expressa em BNF. Para uma definição formal, consulte o artigo da Wikipédia sobre gramática livre de contexto.
Tipos de analisadores
Há dois tipos de analisadores: de cima para baixo e de baixo para cima. Uma explicação intuitiva é que os analisadores de cima para baixo examinam a estrutura de alto nível da sintaxe e tentam encontrar uma correspondência de regra. Os analisadores de baixo para cima começam com a entrada e a transformam gradualmente nas regras de sintaxe, começando pelas regras de baixo nível até que as regras de alto nível sejam atendidas.
Vamos ver como os dois tipos de analisadores vão analisar nosso exemplo.
O analisador de cima para baixo vai começar pela regra de nível mais alto: ele vai identificar 2 + 3 como uma expressão. Em seguida, ele vai identificar 2 + 3 - 1 como uma expressão (o processo de identificação da expressão evolui, correspondendo às outras regras, mas o ponto de partida é a regra de nível mais alto).
O analisador de baixo para cima vai verificar a entrada até que uma regra seja correspondida. Em seguida, ela vai substituir a entrada correspondente pela regra. Isso vai continuar até o final da entrada. A expressão parcialmente correspondente é colocada na pilha do analisador.
Esse tipo de analisador ascendente é chamado de analisador shift-reduce, porque a entrada é deslocada para a direita (imagine um ponteiro apontando primeiro para o início da entrada e se movendo para a direita) e é gradualmente reduzida a regras de sintaxe.
Como gerar analisadores automaticamente
Há ferramentas que podem gerar um analisador. Você fornece a gramática do seu idioma (o vocabulário e as regras de sintaxe) e eles geram um analisador funcional. Criar um analisador requer um entendimento profundo de análise, e não é fácil criar um analisador otimizado manualmente. Por isso, os geradores de analisadores podem ser muito úteis.
O WebKit usa dois geradores de analisadores bem conhecidos: o Flex para criar um analisador léxico e o Bison para criar um analisador (você pode encontrá-los com os nomes Lex e Yacc). A entrada do Flex é um arquivo que contém definições de expressão regular dos tokens. A entrada do Bison são as regras de sintaxe da linguagem no formato BNF.
Analisador de HTML
O trabalho do analisador de HTML é analisar a marcação HTML em uma árvore de análise.
Gramática HTML
O vocabulário e a sintaxe do HTML são definidos em especificações criadas pela organização W3C.
Como vimos na introdução à análise, a sintaxe gramatical pode ser definida formalmente usando formatos como BNF.
Infelizmente, todos os tópicos de analisadores convencionais não se aplicam ao HTML (não os mencionei apenas por diversão, eles serão usados na análise de CSS e JavaScript). O HTML não pode ser facilmente definido por uma gramática livre de contexto, que é necessária para os analisadores.
Há um formato formal para definir HTML, o DTD (Document Type Definition), mas ele não é uma gramática livre de contexto.
Isso parece estranho à primeira vista, já que o HTML é bastante parecido com o XML. Há muitos analisadores XML disponíveis. Há uma variação XML do HTML, o XHTML. Então, qual é a grande diferença?
A diferença é que a abordagem HTML é mais "permissiva": ela permite omitir determinadas tags (que são adicionadas implicitamente) ou, às vezes, omitir tags de início ou fim, entre outras coisas. No geral, é uma sintaxe "suave", ao contrário da sintaxe rígida e exigente do XML.
Esse detalhe aparentemente pequeno faz uma grande diferença. Por um lado, esse é o principal motivo pelo qual o HTML é tão popular: ele perdoa seus erros e facilita a vida do autor da Web. Por outro lado, isso dificulta a criação de uma gramática formal. Resumindo, o HTML não pode ser analisado facilmente por analisadores convencionais, já que a gramática dele não é livre de contexto. O HTML não pode ser analisado por analisadores XML.
DTD HTML
A definição de HTML está em um formato DTD. Esse formato é usado para definir linguagens da família SGML. O formato contém definições para todos os elementos permitidos, os atributos e a hierarquia deles. Como vimos anteriormente, a DTD do HTML não forma uma gramática livre de contexto.
Há algumas variações da DTD. O modo estrito segue apenas as especificações, mas outros modos oferecem suporte para marcações usadas por navegadores no passado. O objetivo é a compatibilidade com versões anteriores de conteúdo mais antigo. O DTD estrito atual está aqui: www.w3.org/TR/html4/strict.dtd
DOM
A árvore de saída (a "árvore de análise") é uma árvore de nós de elementos e atributos do DOM. DOM é a sigla em inglês para Modelo de Objeto de Documentos. É a representação de objeto do documento HTML e a interface de elementos HTML para o mundo externo, como o JavaScript.
A raiz da árvore é o objeto "Document".
O DOM tem uma relação de quase um para um com a marcação. Exemplo:
<html>
  <body>
    <p>
      Hello World
    </p>
    <div> <img src="example.png"/></div>
  </body>
</html>
Essa marcação seria traduzida para a seguinte árvore do DOM:
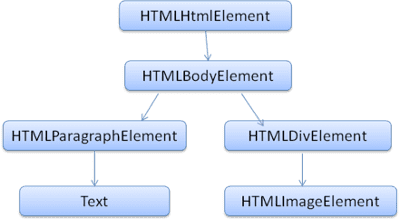
Assim como o HTML, o DOM é especificado pela organização W3C. Consulte www.w3.org/DOM/DOMTR. É uma especificação genérica para manipular documentos. Um módulo específico descreve elementos específicos de HTML. As definições de HTML podem ser encontradas aqui: www.w3.org/TR/2003/REC-DOM-Level-2-HTML-20030109/idl-definitions.html.
Quando digo que a árvore contém nós DOM, quero dizer que ela é construída com elementos que implementam uma das interfaces DOM. Os navegadores usam implementações concretas que têm outros atributos usados internamente pelo navegador.
O algoritmo de análise
Como vimos nas seções anteriores, o HTML não pode ser analisado usando os analisadores comuns de cima para baixo ou de baixo para cima.
Estes são os motivos:
- A natureza tolerante da linguagem.
- O fato de os navegadores terem tolerância tradicional a erros para oferecer suporte a casos conhecidos de HTML inválido.
- O processo de análise é reentrante. Em outras linguagens, a origem não muda durante a análise, mas, em HTML, o código dinâmico (como elementos de script que contêm chamadas
document.write()) pode adicionar tokens extras, de modo que o processo de análise realmente modifica a entrada.
Como não é possível usar as técnicas de análise comuns, os navegadores criam analisadores personalizados para analisar o HTML.
O algoritmo de análise é descrito em detalhes pela especificação HTML5. O algoritmo consiste em duas etapas: tokenização e construção de árvore.
A tokenização é a análise léxica, que analisa a entrada em tokens. Entre os tokens HTML estão tags de início, tags de fim, nomes de atributos e valores de atributos.
O tokenizador reconhece o token, o fornece ao construtor de árvore e consome o próximo caractere para reconhecer o próximo token, e assim por diante até o final da entrada.

O algoritmo de tokenização
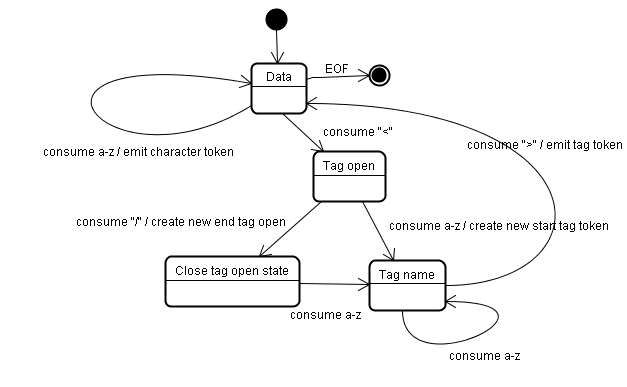
A saída do algoritmo é um token HTML. O algoritmo é expresso como uma máquina de estados. Cada estado consome um ou mais caracteres do fluxo de entrada e atualiza o próximo estado de acordo com esses caracteres. A decisão é influenciada pelo estado atual da tokenização e pelo estado de construção da árvore. Isso significa que o mesmo caractere consumido vai gerar resultados diferentes para o próximo estado correto, dependendo do estado atual. O algoritmo é complexo demais para ser descrito em detalhes. Por isso, vamos ver um exemplo simples que vai nos ajudar a entender o princípio.
Exemplo básico: tokenização do seguinte HTML:
<html>
  <body>
    Hello world
  </body>
</html>
O estado inicial é o "estado de dados".
Quando o caractere < é encontrado, o estado muda para "Tag open state".
O consumo de um caractere a-z faz com que um "token de tag de início" seja criado, e o estado é alterado para "Estado do nome da tag".
Permanecemos nesse estado até que o caractere > seja consumido. Cada caractere é anexado ao novo nome do token. No nosso caso, o token criado é um token html.
Quando a tag > é alcançada, o token atual é emitido e o estado volta para "Estado de dados".
A tag <body> será tratada pelas mesmas etapas.
Até agora, as tags html e body foram emitidas. Agora voltamos ao "Estado dos dados".
Consumir o caractere H de Hello world vai causar a criação e a emissão de um token de caractere, o que continua até que o < de </body> seja alcançado. Vamos emitir um token de caractere para cada caractere de Hello world.
Agora voltamos ao "Estado aberto da tag".
O consumo da próxima entrada / vai causar a criação de um end tag token e uma mudança para o "Estado do nome da tag". Novamente, permanecemos nesse estado até chegarmos a >.Em seguida, o novo token de tag será emitido e voltaremos ao "estado de dados".
A entrada </html> será tratada como no caso anterior.
Algoritmo de construção em árvore
Quando o analisador é criado, o objeto Document também é criado. Durante a fase de construção da árvore, a árvore do DOM com o documento na raiz será modificada, e elementos serão adicionados a ela. Cada nó emitido pelo tokenizador será processado pelo construtor de árvore. Para cada token, a especificação define qual elemento DOM é relevante e será criado para ele. O elemento é adicionado à árvore do DOM e também à pilha de elementos abertos. Essa pilha é usada para corrigir incompatibilidades de aninhamento e tags não fechadas. O algoritmo também é descrito como uma máquina de estados. Os estados são chamados de "modos de inserção".
Vamos ver o processo de construção da árvore para o exemplo de entrada:
<html>
  <body>
    Hello world
  </body>
</html>
A entrada para a etapa de construção da árvore é uma sequência de tokens da etapa de tokenização. O primeiro é o modo inicial. O recebimento do token "html" vai causar uma mudança para o modo "before html" e um reprocessamento do token nesse modo. Isso vai causar a criação do elemento HTMLHtmlElement, que será anexado ao objeto Document raiz.
O estado será alterado para "before head". O token "body" é recebido. Um HTMLHeadElement será criado implicitamente, embora não tenhamos um token "head", e será adicionado à árvore.
Agora, passamos para o modo "in head" e, em seguida, para "after head". O token do corpo é reprocessado, um HTMLBodyElement é criado e inserido, e o modo é transferido para "in body".
Os tokens de caracteres da string "Hello world" foram recebidos. O primeiro vai causar a criação e a inserção de um nó "Text", e os outros caracteres serão anexados a esse nó.
O recebimento do token de fim do corpo vai causar uma transferência para o modo "after body". Agora vamos receber a tag de fechamento html, que vai nos mover para o modo "after after body". Receber o token de fim de arquivo encerra a análise.

Ações quando a análise é concluída
Nesse estágio, o navegador marca o documento como interativo e começa a analisar os scripts que estão no modo "adiado", ou seja, aqueles que devem ser executados após a análise do documento. O estado do documento será definido como "concluído" e um evento "load" será acionado.
Confira todos os algoritmos de tokenização e construção de árvore na especificação do HTML5.
Tolerância a erros dos navegadores
Você nunca recebe um erro de "Sintaxe inválida" em uma página HTML. Os navegadores corrigem qualquer conteúdo inválido e continuam.
Veja este HTML, por exemplo:
<html>
  <mytag>
  </mytag>
  <div>
  <p>
  </div>
    Really lousy HTML
  </p>
</html>
Devo ter violado cerca de um milhão de regras ("mytag" não é uma etiqueta de competências padrão, aninhamento incorreto dos elementos "p" e "div" e muito mais), mas o navegador ainda mostra o conteúdo corretamente e não reclama. Portanto, grande parte do código do analisador corrige os erros do autor do HTML.
O tratamento de erros é bastante consistente nos navegadores, mas, por incrível que pareça, não faz parte das especificações do HTML. Assim como os favoritos e os botões de voltar/avançar, é algo que foi desenvolvido nos navegadores ao longo dos anos. Existem construções HTML inválidas conhecidas que são repetidas em muitos sites, e os navegadores tentam corrigi-las de uma forma que seja compatível com outros navegadores.
A especificação HTML5 define alguns desses requisitos. O WebKit resume isso muito bem no comentário no início da classe do analisador de HTML.
O analisador analisa a entrada tokenizada no documento, criando a árvore de documentos. Se o documento estiver bem formado, a análise será simples.
Infelizmente, precisamos lidar com muitos documentos HTML que não estão bem formados, então o analisador precisa ser tolerante com erros.
Precisamos cuidar de pelo menos as seguintes condições de erro:
- O elemento que está sendo adicionado é explicitamente proibido dentro de alguma tag externa. Nesse caso, feche todas as tags até aquela que proíbe o elemento e adicione-o depois.
- Não podemos adicionar o elemento diretamente. Pode ser que a pessoa que escreveu o documento tenha esquecido alguma tag no meio (ou que a tag no meio seja opcional). Esse pode ser o caso das seguintes tags: HTML HEAD BODY TBODY TR TD LI (esqueci alguma?).
- Queremos adicionar um elemento de bloco dentro de um elemento inline. Fecha todos os elementos inline até o próximo elemento de bloco superior.
- Se isso não ajudar, feche os elementos até que seja possível adicionar o elemento ou ignore a tag.
Vamos ver alguns exemplos de tolerância a erros do WebKit:
</br> em vez de <br>
Alguns sites usam </br> em vez de <br>. Para ser compatível com o IE e o Firefox, o WebKit trata isso como <br>.
O código:
if (t->isCloseTag(brTag) && m_document->inCompatMode()) {
     reportError(MalformedBRError);
     t->beginTag = true;
}
O tratamento de erros é interno, ou seja, não é apresentado ao usuário.
Uma tabela perdida
Uma tabela perdida é uma tabela dentro de outra tabela, mas não dentro de uma célula de tabela.
Exemplo:
<table>
  <table>
    <tr><td>inner table</td></tr>
  </table>
  <tr><td>outer table</td></tr>
</table>
O WebKit vai mudar a hierarquia para duas tabelas irmãs:
<table>
  <tr><td>outer table</td></tr>
</table>
<table>
  <tr><td>inner table</td></tr>
</table>
O código:
if (m_inStrayTableContent && localName == tableTag)
        popBlock(tableTag);
O WebKit usa uma pilha para o conteúdo do elemento atual: ele vai remover a tabela interna da pilha da tabela externa. As tabelas agora serão irmãs.
Elementos de formulário aninhados
Se o usuário colocar um formulário dentro de outro, o segundo será ignorado.
O código:
if (!m_currentFormElement) {
        m_currentFormElement = new HTMLFormElement(formTag,    m_document);
}
Uma hierarquia de tags muito profunda
O comentário fala por si só.
bool HTMLParser::allowNestedRedundantTag(const AtomicString& tagName)
{

unsigned i = 0;
for (HTMLStackElem* curr = m_blockStack;
         i < cMaxRedundantTagDepth && curr && curr->tagName == tagName;
     curr = curr->next, i++) { }
return i != cMaxRedundantTagDepth;
}
Tags de fechamento html ou body fora do lugar
O comentário fala por si só.
if (t->tagName == htmlTag || t->tagName == bodyTag )
        return;
Portanto, autores da Web, tenham cuidado: a menos que queiram aparecer como exemplo em um snippet de código de tolerância a erros do WebKit, escrevam um HTML bem formado.
Análise de CSS
Lembra dos conceitos de análise sintática na introdução? Ao contrário do HTML, o CSS é uma gramática livre de contexto e pode ser analisado usando os tipos de analisadores descritos na introdução. Na verdade, a especificação do CSS define a gramática lexical e de sintaxe do CSS.
Confira alguns exemplos:
A gramática lexical (vocabulário) é definida por expressões regulares para cada token:
comment   \/\*[^*]*\*+([^/*][^*]*\*+)*\/
num       [0-9]+|[0-9]*"."[0-9]+
nonascii  [\200-\377]
nmstart   [_a-z]|{nonascii}|{escape}
nmchar    [_a-z0-9-]|{nonascii}|{escape}
name      {nmchar}+
ident     {nmstart}{nmchar}*
"ident" é a abreviação de identificador, como um nome de classe. "name" é um ID de elemento (que é referenciado por "#" )
A gramática da sintaxe é descrita em BNF.
ruleset
  : selector [ ',' S* selector ]*
    '{' S* declaration [ ';' S* declaration ]* '}' S*
  ;
selector
  : simple_selector [ combinator selector | S+ [ combinator? selector ]? ]?
  ;
simple_selector
  : element_name [ HASH | class | attrib | pseudo ]*
  | [ HASH | class | attrib | pseudo ]+
  ;
class
  : '.' IDENT
  ;
element_name
  : IDENT | '*'
  ;
attrib
  : '[' S* IDENT S* [ [ '=' | INCLUDES | DASHMATCH ] S*
    [ IDENT | STRING ] S* ] ']'
  ;
pseudo
  : ':' [ IDENT | FUNCTION S* [IDENT S*] ')' ]
  ;
Explicação:
Um conjunto de regras tem esta estrutura:
div.error, a.error {
  color:red;
  font-weight:bold;
}
div.error e a.error são seletores. A parte dentro das chaves contém as regras que são aplicadas por esse conjunto de regras.
Essa estrutura é definida formalmente nesta definição:
ruleset
  : selector [ ',' S* selector ]*
    '{' S* declaration [ ';' S* declaration ]* '}' S*
  ;
Isso significa que um conjunto de regras é um seletor ou, opcionalmente, um número de seletores separados por uma vírgula e espaços (S significa espaço em branco). Um conjunto de regras contém chaves e, dentro delas, uma declaração ou, opcionalmente, várias declarações separadas por ponto e vírgula. "declaration" e "selector" serão definidos nas definições de BNF a seguir.
Analisador de CSS do WebKit
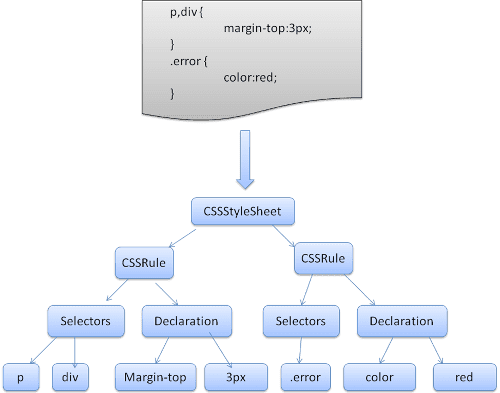
O WebKit usa os geradores de analisador Flex e Bison para criar analisadores automaticamente com base nos arquivos de gramática CSS. Como você se lembra da introdução ao analisador, o Bison cria um analisador de deslocamento-redução de baixo para cima. O Firefox usa um analisador descendente escrito manualmente. Em ambos os casos, cada arquivo CSS é analisado em um objeto StyleSheet. Cada objeto contém regras de CSS. Os objetos de regra CSS contêm objetos de seletor e declaração, além de outros objetos correspondentes à gramática CSS.
Ordem de processamento de scripts e folhas de estilo
Scripts
O modelo da Web é síncrono. Os autores esperam que os scripts sejam analisados e executados imediatamente quando o analisador chega a uma tag <script>.
A análise do documento é interrompida até que o script seja executado.
Se o script for externo, o recurso precisará ser buscado primeiro na rede. Isso também é feito de forma síncrona, e a análise é interrompida até que o recurso seja buscado.
Esse foi o modelo por muitos anos e também é especificado nas especificações HTML4 e 5.
Os autores podem adicionar o atributo "defer" a um script. Nesse caso, ele não interrompe a análise do documento e é executado após a análise. O HTML5 adiciona uma opção para marcar o script como assíncrono, de modo que ele seja analisado e executado por uma linha de execução diferente.
Análise especulativa
O WebKit e o Firefox fazem essa otimização. Enquanto os scripts são executados, outra linha de execução analisa o restante do documento e descobre quais outros recursos precisam ser carregados da rede e os carrega. Dessa forma, os recursos podem ser carregados em conexões paralelas, e a velocidade geral é melhorada. Observação: o analisador especulativo só analisa referências a recursos externos, como scripts, folhas de estilo e imagens externos. Ele não modifica a árvore do DOM, que é deixada para o analisador principal.
Folhas de estilo
As folhas de estilo, por outro lado, têm um modelo diferente. Conceitualmente, como as folhas de estilo não mudam a árvore do DOM, não há motivo para esperar por elas e interromper a análise do documento. No entanto, há um problema com scripts que solicitam informações de estilo durante a etapa de análise do documento. Se o estilo ainda não tiver sido carregado e analisado, o script vai receber respostas erradas, o que aparentemente causou muitos problemas. Parece ser um caso extremo, mas é bastante comum. O Firefox bloqueia todos os scripts quando há uma folha de estilo que ainda está sendo carregada e analisada. O WebKit bloqueia scripts apenas quando eles tentam acessar determinadas propriedades de estilo que podem ser afetadas por folhas de estilo não carregadas.
Construção da árvore de renderização
Enquanto a árvore do DOM está sendo construída, o navegador constrói outra árvore, a de renderização. Essa árvore é de elementos visuais na ordem em que serão exibidos. É a representação visual do documento. O objetivo dessa árvore é permitir a pintura do conteúdo na ordem correta.
O Firefox chama os elementos na árvore de renderização de "frames". O WebKit usa o termo renderizador ou objeto de renderização.
Um renderizador sabe como organizar e pintar a si mesmo e os filhos.
A classe RenderObject do WebKit, a classe de base dos renderizadores, tem a seguinte definição:
class RenderObject{
  virtual void layout();
  virtual void paint(PaintInfo);
  virtual void rect repaintRect();
  Node* node;  //the DOM node
  RenderStyle* style;  // the computed style
  RenderLayer* containgLayer; //the containing z-index layer
}
Cada renderizador representa uma área retangular que geralmente corresponde à caixa CSS de um nó, conforme descrito pela especificação CSS2. Ele inclui informações geométricas, como largura, altura e posição.
O tipo de caixa é afetado pelo valor "display" do atributo de estilo relevante para o nó (consulte a seção Cálculo de estilo). Este é o código do WebKit para decidir que tipo de renderizador deve ser criado para um nó do DOM, de acordo com o atributo de exibição:
RenderObject* RenderObject::createObject(Node* node, RenderStyle* style)
{
    Document* doc = node->document();
    RenderArena* arena = doc->renderArena();
    ...
    RenderObject* o = 0;

    switch (style->display()) {
        case NONE:
            break;
        case INLINE:
            o = new (arena) RenderInline(node);
            break;
        case BLOCK:
            o = new (arena) RenderBlock(node);
            break;
        case INLINE_BLOCK:
            o = new (arena) RenderBlock(node);
            break;
        case LIST_ITEM:
            o = new (arena) RenderListItem(node);
            break;
       ...
    }

    return o;
}
O tipo de elemento também é considerado: por exemplo, controles de formulário e tabelas têm frames especiais.
No WebKit, se um elemento quiser criar um renderizador especial, ele vai substituir o método createRenderer().
Os renderizadores apontam para objetos de estilo que contêm informações não geométricas.
A relação da árvore de renderização com a árvore do DOM
Os renderizadores correspondem aos elementos do DOM, mas a relação não é de um para um. Os elementos DOM não visuais não serão inseridos na árvore de renderização. Um exemplo é o elemento "head". Além disso, os elementos com o valor de exibição "none" não vão aparecer na árvore, ao contrário dos elementos com visibilidade "hidden".
Há elementos DOM que correspondem a vários objetos visuais. Geralmente, são elementos com estrutura complexa que não podem ser descritos por um único retângulo. Por exemplo, o elemento "select" tem três renderizadores: um para a área de exibição, um para a caixa de listagem suspensa e um para o botão. Além disso, quando o texto é dividido em várias linhas porque a largura não é suficiente para uma linha, as novas linhas são adicionadas como renderizadores extras.
Outro exemplo de renderizadores múltiplos é o HTML corrompido. De acordo com a especificação CSS, um elemento inline precisa conter apenas elementos de bloco ou apenas elementos inline. No caso de conteúdo misto, renderizadores de blocos anônimos serão criados para envolver os elementos inline.
Alguns objetos de renderização correspondem a um nó do DOM, mas não no mesmo lugar na árvore. Os elementos flutuantes e posicionados de forma absoluta estão fora do fluxo, colocados em uma parte diferente da árvore e mapeados para o frame real. Um frame de marcador de posição é onde eles deveriam estar.

O fluxo de construção da árvore
No Firefox, a apresentação é registrada como um listener para atualizações do DOM.
A apresentação delega a criação de frames ao FrameConstructor, e o construtor resolve o estilo (consulte cálculo de estilo) e cria um frame.
No WebKit, o processo de resolver o estilo e criar um renderizador é chamado de "anexo". Cada nó do DOM tem um método "attach". A anexação é síncrona, e a inserção do nó na árvore do DOM chama o método "attach" do novo nó.
O processamento das tags html e body resulta na construção da raiz da árvore de renderização.
O objeto de renderização raiz corresponde ao que a especificação CSS chama de bloco de contenção: o bloco superior que contém todos os outros blocos. As dimensões dele são a janela de visualização: as dimensões da área de exibição da janela do navegador.
O Firefox o chama de ViewPortFrame, e o WebKit o chama de RenderView.
Este é o objeto de renderização para o qual o documento aponta.
O restante da árvore é construído como uma inserção de nós do DOM.
Consulte a especificação CSS2 sobre o modelo de processamento.
Cálculo de estilo
A criação da árvore de renderização requer o cálculo das propriedades visuais de cada objeto de renderização. Isso é feito calculando as propriedades de estilo de cada elemento.
O estilo inclui folhas de estilo de várias origens, elementos de estilo inline e propriedades visuais no HTML (como a propriedade "bgcolor").O último é traduzido para propriedades de estilo CSS correspondentes.
As origens das folhas de estilo são as folhas de estilo padrão do navegador, as folhas de estilo fornecidas pelo autor da página e as folhas de estilo do usuário, que são fornecidas pelo usuário do navegador (os navegadores permitem que você defina seus estilos favoritos). No Firefox, por exemplo, isso é feito colocando uma folha de estilo na pasta "Firefox Profile".
O cálculo de estilo traz algumas dificuldades:
- Os dados de estilo são uma construção muito grande, que contém as inúmeras propriedades de estilo, o que pode causar problemas de memória.
Encontrar as regras correspondentes para cada elemento pode causar problemas de desempenho se não for otimizado. Percorrer toda a lista de regras para cada elemento para encontrar correspondências é uma tarefa pesada. Os seletores podem ter uma estrutura complexa que faz com que o processo de correspondência comece em um caminho aparentemente promissor, mas que se mostra inútil, e outro caminho precisa ser testado.
Por exemplo, este seletor composto:
div div div div{
...
}
Significa que as regras se aplicam a um
<div>que é descendente de três divs. Suponha que você queira verificar se a regra se aplica a um determinado elemento<div>. Você escolhe um determinado caminho na árvore para verificação. Talvez seja necessário percorrer a árvore de nós para descobrir que há apenas duas divs e que a regra não se aplica. Em seguida, você precisa tentar outros caminhos na árvore.A aplicação das regras envolve regras em cascata bastante complexas que definem a hierarquia das regras.
Vamos ver como os navegadores lidam com esses problemas:
Compartilhamento de dados de estilo
Os nós do WebKit fazem referência a objetos de estilo (RenderStyle). Esses objetos podem ser compartilhados por nós em algumas condições. Os nós são irmãos ou primos e:
- Os elementos precisam estar no mesmo estado do mouse (por exemplo, um não pode estar em :hover enquanto o outro não está)
- Nenhum elemento deve ter um ID
- Os nomes das tags precisam corresponder
- Os atributos de classe precisam corresponder
- O conjunto de atributos mapeados precisa ser idêntico
- Os estados do link precisam ser iguais
- Os estados de foco precisam ser iguais
- Nenhum elemento deve ser afetado por seletores de atributos, em que "afetado" é definido como ter qualquer correspondência de seletor que use um seletor de atributos em qualquer posição dentro do seletor.
- Não pode haver nenhum atributo de estilo inline nos elementos
- Não pode haver nenhum seletor irmão em uso. O WebCore simplesmente aciona uma chave global quando qualquer seletor irmão é encontrado e desativa o compartilhamento de estilo para todo o documento quando eles estão presentes. Isso inclui o seletor + e seletores como :first-child e :last-child.
Árvore de regras do Firefox
O Firefox tem duas árvores extras para facilitar o cálculo de estilo: a árvore de regras e a árvore de contexto de estilo. O WebKit também tem objetos de estilo, mas eles não são armazenados em uma árvore como a árvore de contexto de estilo. Somente o nó DOM aponta para o estilo relevante.
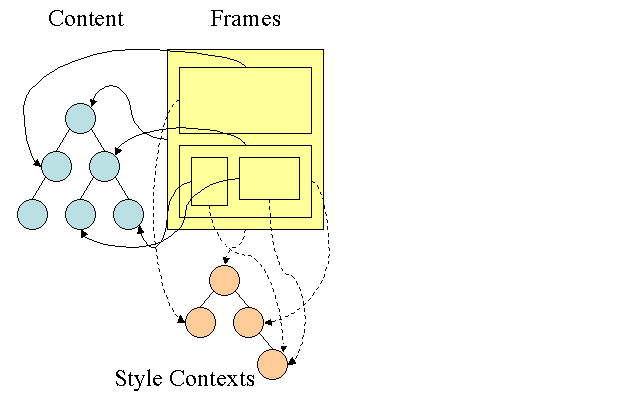
Os contextos de estilo contêm valores finais. Os valores são calculados aplicando todas as regras de correspondência na ordem correta e realizando manipulações que os transformam de valores lógicos em concretos. Por exemplo, se o valor lógico for uma porcentagem da tela, ele será calculado e transformado em unidades absolutas. A ideia da árvore de regras é muito inteligente. Ele permite compartilhar esses valores entre nós para evitar que sejam calculados novamente. Isso também economiza espaço.
Todas as regras correspondentes são armazenadas em uma árvore. Os nós inferiores em um caminho têm prioridade mais alta. A árvore contém todos os caminhos para as correspondências de regras encontradas. O armazenamento das regras é feito de forma lenta. A árvore não é calculada no início para cada nó, mas sempre que um estilo de nó precisa ser calculado, os caminhos calculados são adicionados à árvore.
A ideia é ver os caminhos da árvore como palavras em um léxico. Digamos que já calculamos esta árvore de regras:

Suponha que precisamos corresponder regras para outro elemento na árvore de conteúdo e descobrir que as regras correspondentes (na ordem correta) são B-E-I. Já temos esse caminho na árvore porque já calculamos o caminho A-B-E-I-L. Agora teremos menos trabalho.
Vamos ver como a árvore nos poupa trabalho.
Divisão em structs
Os contextos de estilo são divididos em structs. Essas structs contêm informações de estilo para uma determinada categoria, como borda ou cor. Todas as propriedades em uma struct são herdadas ou não herdadas. As propriedades herdadas são aquelas que, a menos que sejam definidas pelo elemento, são herdadas do elemento pai. As propriedades não herdadas (chamadas de propriedades de "redefinição") usam valores padrão se não forem definidas.
A árvore nos ajuda armazenando em cache structs inteiros (que contêm os valores finais calculados). A ideia é que, se o nó inferior não fornecer uma definição para um struct, um struct armazenado em cache em um nó superior poderá ser usado.
Como calcular os contextos de estilo usando a árvore de regras
Ao calcular o contexto de estilo de um determinado elemento, primeiro calculamos um caminho na árvore de regras ou usamos um que já existe. Em seguida, começamos a aplicar as regras no caminho para preencher as structs no novo contexto de estilo. Começamos no nó inferior do caminho, que tem a maior precedência (geralmente o seletor mais específico), e percorremos a árvore até que a struct esteja cheia. Se não houver uma especificação para o struct nesse nó de regra, podemos otimizar bastante: subimos na árvore até encontrar um nó que o especifique totalmente e apontamos para ele. Essa é a melhor otimização, já que todo o struct é compartilhado. Isso economiza o cálculo de valores finais e memória.
Se encontrarmos definições parciais, subiremos na árvore até que a estrutura seja preenchida.
Se não encontrarmos nenhuma definição para nossa struct, caso ela seja um tipo "herdado", apontaremos para a struct do pai na árvore de contexto. Nesse caso, também conseguimos compartilhar structs. Se for uma estrutura de redefinição, os valores padrão serão usados.
Se o nó mais específico adicionar valores, será necessário fazer alguns cálculos extras para transformá-los em valores reais. Em seguida, armazenamos o resultado em cache no nó da árvore para que ele possa ser usado pelos filhos.
Se um elemento tiver um irmão que aponte para o mesmo nó da árvore, o contexto de estilo inteiro poderá ser compartilhado entre eles.
Vamos ver um exemplo: suponha que temos este HTML
<html>
  <body>
    <div class="err" id="div1">
      <p>
        this is a <span class="big"> big error </span>
        this is also a
        <span class="big"> very  big  error</span> error
      </p>
    </div>
    <div class="err" id="div2">another error</div>
  </body>
</html>
E as seguintes regras:
div {margin: 5px; color:black}
.err {color:red}
.big {margin-top:3px}
div span {margin-bottom:4px}
#div1 {color:blue}
#div2 {color:green}
Para simplificar, digamos que precisamos preencher apenas dois structs: o de cor e o de margem. A estrutura de cor contém apenas um membro: a cor. A estrutura de margem contém os quatro lados.
A árvore de regras resultante será semelhante a esta (os nós são marcados com o nome do nó: o número da regra para que apontam):
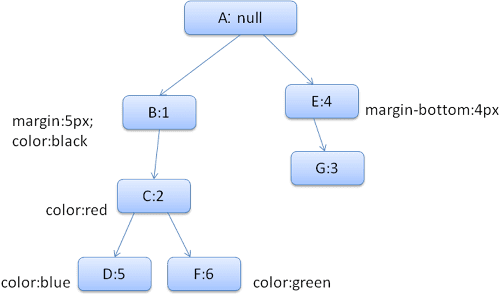
A árvore de contexto vai ficar assim (nome do nó: nó de regra para o qual eles apontam):

Suponha que analisamos o HTML e chegamos à segunda tag <div>. Precisamos criar um contexto de estilo para esse nó e preencher as structs de estilo dele.
Vamos fazer a correspondência das regras e descobrir que as regras correspondentes para o <div> são 1, 2 e 6.
Isso significa que já existe um caminho na árvore que nosso elemento pode usar, e só precisamos adicionar outro nó a ele para a regra 6 (nó F na árvore de regras).
Vamos criar um contexto de estilo e colocá-lo na árvore de contexto. O novo contexto de estilo vai apontar para o nó F na árvore de regras.
Agora precisamos preencher as structs de estilo. Vamos começar preenchendo a estrutura de margem. Como o último nó de regra (F) não adiciona à estrutura de margem, podemos subir na árvore até encontrar uma estrutura em cache calculada em uma inserção de nó anterior e usá-la. Vamos encontrá-la no nó B, que é o nó mais alto que especificou regras de margem.
Temos uma definição para a struct de cor, então não podemos usar uma struct em cache. Como a cor tem um atributo, não precisamos subir na árvore para preencher outros atributos. Vamos calcular o valor final (converter string em RGB etc.) e armazenar em cache a estrutura calculada nesse nó.
O trabalho no segundo elemento <span> é ainda mais fácil. Vamos fazer a correspondência das regras e chegar à conclusão de que ele aponta para a regra G, como o período anterior.
Como temos irmãos que apontam para o mesmo nó, podemos compartilhar todo o contexto de estilo e apenas apontar para o contexto do span anterior.
Para structs que contêm regras herdadas do pai, o armazenamento em cache é feito na árvore de contexto (a propriedade de cor é herdada, mas o Firefox a trata como redefinida e a armazena em cache na árvore de regras).
Por exemplo, se adicionarmos regras para fontes em um parágrafo:
p {font-family: Verdana; font size: 10px; font-weight: bold}
Em seguida, o elemento de parágrafo, que é filho da div na árvore de contexto, poderia ter compartilhado a mesma estrutura de fonte que o pai. Isso acontece se nenhuma regra de fonte tiver sido especificada para o parágrafo.
No WebKit, que não tem uma árvore de regras, as declarações correspondentes são analisadas quatro vezes. Primeiro, são aplicadas as propriedades não importantes de alta prioridade (propriedades que precisam ser aplicadas primeiro porque outras dependem delas, como display), depois as importantes de alta prioridade, depois as não importantes de prioridade normal e, por fim, as regras importantes de prioridade normal. Isso significa que as propriedades que aparecem várias vezes serão resolvidas de acordo com a ordem correta de cascata. A última vence.
Resumindo: compartilhar os objetos de estilo (totalmente ou algumas das estruturas dentro deles) resolve os problemas 1 e 3. A árvore de regras do Firefox também ajuda a aplicar as propriedades na ordem correta.
Manipular as regras para facilitar a correspondência
Há várias fontes para regras de estilo:
- Regras de CSS, em folhas de estilo externas ou em elementos de estilo.
css p {color: blue} - Atributos de estilo inline, como
html <p style="color: blue" /> - Atributos visuais HTML (que são mapeados para regras de estilo relevantes)
html
<p bgcolor="blue" />
Os dois últimos são facilmente associados ao elemento, já que ele é o proprietário dos atributos de estilo, e os atributos HTML podem ser mapeados usando o elemento como chave.
Como observado anteriormente no problema nº 2, a correspondência de regras CSS pode ser mais complicada. Para resolver a dificuldade, as regras são manipuladas para facilitar o acesso.
Depois de analisar a folha de estilo, as regras são adicionadas a um dos vários mapas de hash, de acordo com o seletor. Há mapas por ID, por nome de classe, por nome de tag e um mapa geral para tudo que não se encaixa nessas categorias. Se o seletor for um ID, a regra será adicionada ao mapa de IDs. Se for uma classe, ela será adicionada ao mapa de classes etc.
Essa manipulação facilita muito a correspondência de regras. Não é necessário analisar todas as declarações: podemos extrair as regras relevantes para um elemento dos mapas. Essa otimização elimina mais de 95% das regras, de modo que elas nem precisam ser consideradas durante o processo de correspondência(4.1).
Por exemplo, considere as seguintes regras de estilo:
p.error {color: red}
#messageDiv {height: 50px}
div {margin: 5px}
A primeira regra será inserida no mapa de classes. O segundo no mapa de IDs e o terceiro no mapa de tags.
Para o seguinte fragmento HTML:
<p class="error">an error occurred</p>
<div id=" messageDiv">this is a message</div>
Primeiro, vamos tentar encontrar regras para o elemento p. O mapa de classes vai conter uma chave "error" em que a regra para "p.error" é encontrada. O elemento div terá regras relevantes no mapa de ID (a chave é o ID) e no mapa de tags. Portanto, o único trabalho restante é descobrir quais das regras extraídas pelas chaves realmente correspondem.
Por exemplo, se a regra para a div fosse:
table div {margin: 5px}
Ele ainda será extraído do mapa de tags, porque a chave é o seletor mais à direita, mas não corresponderá ao nosso elemento div, que não tem um ancestral de tabela.
O WebKit e o Firefox fazem essa manipulação.
Ordem em cascata da folha de estilo
O objeto de estilo tem propriedades que correspondem a cada atributo visual (todos os atributos CSS, mas mais genéricos). Se a propriedade não for definida por nenhuma das regras correspondentes, algumas propriedades poderão ser herdadas pelo objeto de estilo do elemento pai. As outras propriedades têm valores padrão.
O problema começa quando há mais de uma definição. É aí que entra a ordem em cascata para resolver o problema.
Uma declaração de uma propriedade de estilo pode aparecer em várias folhas de estilo e várias vezes em uma folha de estilo. Isso significa que a ordem de aplicação das regras é muito importante. Isso é chamado de ordem em cascata. De acordo com a especificação CSS2, a ordem de cascata é (da menor para a maior):
- Declarações do navegador
- Declarações normais do usuário
- Criar declarações normais
- Declarações importantes do autor
- Declarações importantes do usuário
As declarações do navegador são as menos importantes, e o usuário só substitui o autor se a declaração tiver sido marcada como importante. As declarações com a mesma ordem serão classificadas por especificidade e, em seguida, pela ordem em que são especificadas. Os atributos visuais HTML são traduzidos para declarações CSS correspondentes . Elas são tratadas como regras de autor com baixa prioridade.
Especificidade
A especificidade do seletor é definida pela especificação CSS2 da seguinte maneira:
- Conte 1 se a declaração for de um atributo "style" em vez de uma regra com um seletor. Caso contrário, conte 0 (= a).
- conte o número de atributos de ID no seletor (= b)
- conte o número de outros atributos e pseudoclasses no seletor (= c)
- conte o número de nomes de elementos e pseudoelementos no seletor (= d)
A concatenação dos quatro números a-b-c-d (em um sistema numérico com uma base grande) fornece a especificidade.
A base numérica que você precisa usar é definida pela contagem mais alta em uma das categorias.
Por exemplo, se a=14, você pode usar a base hexadecimal. No caso improvável de a=17, você precisará de uma base numérica de 17 dígitos. A última situação pode acontecer com um seletor como este: html body div div p… (17 tags no seu seletor… não é muito provável).
Alguns exemplos:
 *             {}  /* a=0 b=0 c=0 d=0 -> specificity = 0,0,0,0 */
 li            {}  /* a=0 b=0 c=0 d=1 -> specificity = 0,0,0,1 */
 li:first-line {}  /* a=0 b=0 c=0 d=2 -> specificity = 0,0,0,2 */
 ul li         {}  /* a=0 b=0 c=0 d=2 -> specificity = 0,0,0,2 */
 ul ol+li      {}  /* a=0 b=0 c=0 d=3 -> specificity = 0,0,0,3 */
 h1 + *[rel=up]{}  /* a=0 b=0 c=1 d=1 -> specificity = 0,0,1,1 */
 ul ol li.red  {}  /* a=0 b=0 c=1 d=3 -> specificity = 0,0,1,3 */
 li.red.level  {}  /* a=0 b=0 c=2 d=1 -> specificity = 0,0,2,1 */
 #x34y         {}  /* a=0 b=1 c=0 d=0 -> specificity = 0,1,0,0 */
 style=""          /* a=1 b=0 c=0 d=0 -> specificity = 1,0,0,0 */
Como classificar as regras
Depois que as regras são correspondidas, elas são classificadas de acordo com as regras em cascata.
O WebKit usa a classificação por flutuação para listas pequenas e a classificação por intercalação para listas grandes.
O WebKit implementa a classificação substituindo o operador > para as regras:
static bool operator >(CSSRuleData& r1, CSSRuleData& r2)
{
    int spec1 = r1.selector()->specificity();
    int spec2 = r2.selector()->specificity();
    return (spec1 == spec2) ? r1.position() > r2.position() : spec1 > spec2;
}
Processo gradual
O WebKit usa uma flag que marca se todas as folhas de estilo de nível superior (incluindo @imports) foram carregadas. Se o estilo não estiver totalmente carregado ao ser anexado, marcadores de posição serão usados e marcados no documento, e serão recalculados quando as folhas de estilo forem carregadas.
Layout
Quando o renderizador é criado e adicionado à árvore, ele não tem uma posição e um tamanho. O cálculo desses valores é chamado de layout ou refluxo.
O HTML usa um modelo de layout baseado em fluxo, o que significa que, na maioria das vezes, é possível calcular a geometria em uma única passagem. Os elementos que aparecem mais adiante "no fluxo" normalmente não afetam a geometria dos elementos que aparecem antes "no fluxo". Assim, o layout pode ser processado da esquerda para a direita e de cima para baixo no documento. Há exceções: por exemplo, as tabelas HTML podem exigir mais de uma passagem.
O sistema de coordenadas é relativo ao frame raiz. As coordenadas superior e esquerda são usadas.
O layout é um processo recursivo. Ele começa no renderizador raiz, que corresponde ao elemento <html> do documento HTML. O layout continua de forma recursiva por parte ou por toda a hierarquia de frames, calculando informações geométricas para cada renderizador que precisa delas.
A posição do renderizador raiz é 0,0, e as dimensões dele são a janela de visualização, ou seja, a parte visível da janela do navegador.
Todos os renderizadores têm um método "layout" ou "reflow", e cada renderizador invoca o método de layout dos filhos que precisam de layout.
Sistema de bits sujos
Para não fazer um layout completo para cada pequena mudança, os navegadores usam um sistema de "bit sujo". Um renderizador que é alterado ou adicionado marca a si mesmo e aos filhos como "sujos", ou seja, que precisam de layout.
Há duas flags: "dirty" e "children are dirty", o que significa que, embora o renderizador em si esteja OK, ele tem pelo menos um filho que precisa de um layout.
Layout global e incremental
O layout pode ser acionado em toda a árvore de renderização, o que é chamado de layout "global". Isso pode acontecer como resultado de:
- Uma mudança de estilo global que afeta todos os renderizadores, como uma mudança no tamanho da fonte.
- Como resultado do redimensionamento de uma tela
O layout pode ser incremental, apenas os renderizadores sujos serão dispostos (isso pode causar alguns danos que exigirão layouts extras).
O layout incremental é acionado (de forma assíncrona) quando os renderizadores estão sujos. Por exemplo, quando novos renderizadores são anexados à árvore de renderização depois que o conteúdo extra veio da rede e foi adicionado à árvore do DOM.

Layout assíncrono e síncrono
O layout incremental é feito de forma assíncrona. O Firefox coloca em fila os "comandos de refluxo" para layouts incrementais, e um programador aciona a execução em lote desses comandos. O WebKit também tem um timer que executa um layout incremental: a árvore é percorrida e os renderizadores "sujos" são dispostos.
Scripts que solicitam informações de estilo, como "offsetHeight", podem acionar o layout incremental de forma síncrona.
O layout global geralmente é acionado de forma síncrona.
Às vezes, o layout é acionado como um callback após um layout inicial porque alguns atributos, como a posição de rolagem, mudaram.
Otimizações
Quando um layout é acionado por um "redimensionamento" ou uma mudança na posição do renderizador(e não no tamanho), os tamanhos de renderização são extraídos de um cache e não são recalculados…
Em alguns casos, apenas uma subárvore é modificada, e o layout não começa na raiz. Isso pode acontecer quando a mudança é local e não afeta o que está ao redor, como texto inserido em campos de texto. Caso contrário, cada pressionamento de tecla acionaria um layout que começa na raiz.
O processo de layout
O layout geralmente tem o seguinte padrão:
- O renderizador pai determina a própria largura.
- O elemento pai analisa os filhos e:
- Posicione o renderizador filho (definindo x e y).
- Chama o layout filho, se necessário (eles estão sujos, estamos em um layout global ou por algum outro motivo), o que calcula a altura do filho.
- O pai usa as alturas acumuladas dos filhos e as alturas das margens e do padding para definir a própria altura, que será usada pelo pai do renderizador pai.
- Define o bit sujo como falso.
O Firefox usa um objeto de "estado" (nsHTMLReflowState) como parâmetro para o layout (chamado de "refluxo"). Entre outros, o estado inclui a largura do pai.
A saída do layout do Firefox é um objeto de "métricas" (nsHTMLReflowMetrics). Ele vai conter a altura calculada do renderizador.
Cálculo da largura
A largura do renderizador é calculada usando a largura do bloco do contêiner, a propriedade "width" do estilo do renderizador, as margens e as bordas.
Por exemplo, a largura da seguinte div:
<div style="width: 30%"/>
Seria calculado pelo WebKit da seguinte forma(método calcWidth da classe RenderBox):
- A largura do contêiner é o máximo de availableWidth e 0. Nesse caso, o availableWidth é o contentWidth, que é calculado da seguinte forma:
clientWidth() - paddingLeft() - paddingRight()
clientWidth e clientHeight representam o interior de um objeto, excluindo a borda e a barra de rolagem.
A largura dos elementos é o atributo de estilo "width". Ele será calculado como um valor absoluto ao calcular a porcentagem da largura do contêiner.
As bordas e os paddings horizontais foram adicionados.
Até agora, esse foi o cálculo da "largura preferencial". Agora as larguras mínima e máxima serão calculadas.
Se a largura preferencial for maior que a máxima, a largura máxima será usada. Se for menor que a largura mínima (a menor unidade inquebrável), a largura mínima será usada.
Os valores são armazenados em cache caso um layout seja necessário, mas a largura não muda.
Quebra de linha
Quando um renderizador no meio de um layout decide que precisa ser quebrado, ele para e informa ao pai do layout que precisa ser quebrado. O pai cria os renderizadores extras e chama o layout neles.
Pintura
Na fase de pintura, a árvore de renderização é percorrida e o método "paint()" do renderizador é chamado para mostrar o conteúdo na tela. A pintura usa o componente de infraestrutura da interface.
Global e incremental
Assim como o layout, a pintura também pode ser global (a árvore inteira é pintada) ou incremental. Na pintura incremental, alguns renderizadores mudam de uma forma que não afeta toda a árvore. O renderizador alterado invalida o retângulo na tela. Isso faz com que o SO o veja como uma "região suja" e gere um evento de "pintura". O SO faz isso de forma inteligente e une várias regiões em uma só. No Chrome, é mais complicado porque o renderizador está em um processo diferente do principal. O Chrome simula o comportamento do SO até certo ponto. A apresentação detecta esses eventos e delega a mensagem à raiz de renderização. A árvore é percorrida até que o renderizador relevante seja alcançado. Ele vai se redesenhar (e geralmente os filhos também).
A ordem de pintura
O CSS2 define a ordem do processo de pintura. Essa é a ordem em que os elementos são empilhados nos contextos de empilhamento. Essa ordem afeta a pintura, já que as pilhas são pintadas de trás para frente. A ordem de empilhamento de um renderizador de blocos é:
- cor do plano de fundo
- imagem de plano de fundo
- border
- crianças
- outline
Lista de exibição do Firefox
O Firefox analisa a árvore de renderização e cria uma lista de exibição para o retângulo pintado. Ele contém os renderizadores relevantes para o retângulo, na ordem de pintura correta (planos de fundo dos renderizadores, depois bordas etc.).
Dessa forma, a árvore precisa ser percorrida apenas uma vez para uma nova pintura, em vez de várias vezes, pintando todos os planos de fundo, depois todas as imagens, depois todas as bordas etc.
O Firefox otimiza o processo não adicionando elementos que serão ocultados, como elementos completamente abaixo de outros elementos opacos.
Armazenamento de retângulo do WebKit
Antes de repintar, o WebKit salva o retângulo antigo como um bitmap. Em seguida, ele pinta apenas o delta entre os retângulos novo e antigo.
Mudanças dinâmicas
Os navegadores tentam realizar o mínimo de ações possível em resposta a uma mudança. Portanto, as mudanças na cor de um elemento só vão causar a repintura dele. As mudanças na posição do elemento vão causar o layout e a repintura do elemento, dos filhos e, possivelmente, dos irmãos. Adicionar um nó DOM vai causar o layout e a repintura do nó. Mudanças importantes, como aumentar o tamanho da fonte do elemento "html", vão invalidar os caches, refazer o layout e repintar toda a árvore.
As linhas de execução do mecanismo de renderização
O mecanismo de renderização tem uma única linha de execução. Quase tudo, exceto as operações de rede, acontece em uma única linha de execução. No Firefox e no Safari, essa é a linha de execução principal do navegador. No Chrome, é a linha de execução principal do processo da guia.
As operações de rede podem ser realizadas por várias linhas de execução paralelas. O número de conexões paralelas é limitado (geralmente de 2 a 6 conexões).
Loop de eventos
A linha de execução principal do navegador é um loop de eventos. É um loop infinito que mantém o processo ativo. Ela aguarda eventos (como eventos de layout e pintura) e os processa. Este é o código do Firefox para o loop de eventos principal:
while (!mExiting)
    NS_ProcessNextEvent(thread);
Modelo visual CSS2
A tela
De acordo com a especificação CSS2, o termo "tela" descreve "o espaço em que a estrutura de formatação é renderizada", ou seja, onde o navegador pinta o conteúdo.
A tela é infinita para cada dimensão do espaço, mas os navegadores escolhem uma largura inicial com base nas dimensões da janela de visualização.
De acordo com www.w3.org/TR/CSS2/zindex.html, a tela será transparente se estiver contida em outra e receberá uma cor definida pelo navegador se não estiver.
Modelo de caixa CSS
O modelo de caixa CSS descreve as caixas retangulares geradas para elementos na árvore de documentos e dispostas de acordo com o modelo de formatação visual.
Cada caixa tem uma área de conteúdo (por exemplo, texto, imagem etc.) e áreas opcionais de padding, borda e margem ao redor.
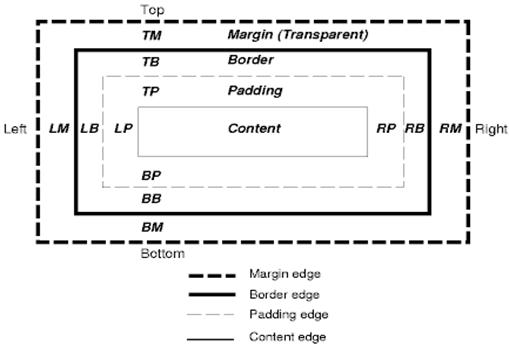
Cada nó gera de 0 a n caixas desse tipo.
Todos os elementos têm uma propriedade "display" que determina o tipo de caixa que será gerada.
Exemplos:
block: generates a block box.
inline: generates one or more inline boxes.
none: no box is generated.
O padrão é inline, mas a folha de estilo do navegador pode definir outros padrões. Por exemplo: a exibição padrão do elemento "div" é "block".
Veja um exemplo de folha de estilo padrão aqui: www.w3.org/TR/CSS2/sample.html.
Esquema de posicionamento
Há três esquemas:
- Normal: o objeto é posicionado de acordo com o lugar dele no documento. Isso significa que o lugar dele na árvore de renderização é como o lugar dele na árvore do DOM e é disposto de acordo com o tipo e as dimensões da caixa.
- Float: o objeto é disposto primeiro como fluxo normal e depois movido o mais para a esquerda ou direita possível.
- Absoluto: o objeto é colocado na árvore de renderização em um lugar diferente da árvore do DOM.
O esquema de posicionamento é definido pela propriedade "position" e pelo atributo "float".
- static e relative causam um fluxo normal
- "absolute" e "fixed" causam posicionamento absoluto
No posicionamento estático, nenhuma posição é definida, e o posicionamento padrão é usado. Nos outros esquemas, o autor especifica a posição: superior, inferior, esquerda, direita.
A forma como a caixa é disposta é determinada por:
- Tipo de caixa
- Dimensões da caixa
- Esquema de posicionamento
- Informações externas, como o tamanho da imagem e da tela
Tipos de Box
Caixa de bloco: forma um bloco, tem o próprio retângulo na janela do navegador.

Caixa inline: não tem um bloco próprio, mas está dentro de um bloco de contêiner.

Os blocos são formatados verticalmente, um após o outro. Os elementos inline são formatados horizontalmente.
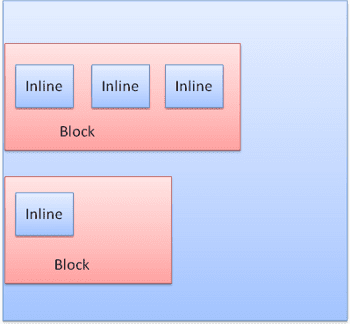
As caixas inline são colocadas dentro de linhas ou "caixas de linha". As linhas são pelo menos tão altas quanto a caixa mais alta, mas podem ser mais altas quando as caixas estão alinhadas com o valor de referência, ou seja, a parte de baixo de um elemento está alinhada em um ponto de outra caixa que não seja a parte de baixo. Se a largura do contêiner não for suficiente, os elementos inline serão colocados em várias linhas. Isso é o que geralmente acontece em um parágrafo.

Posicionamento
Relativo
Posicionamento relativo: posicionado como de costume e, em seguida, movido pelo delta necessário.

Variações
Uma caixa flutuante é deslocada para a esquerda ou direita de uma linha. O recurso interessante é que as outras caixas fluem ao redor dela. O HTML:
<p>
  <img style="float: right" src="images/image.gif" width="100" height="100">
  Lorem ipsum dolor sit amet, consectetuer...
</p>
Será assim:

Absoluto e fixo
O layout é definido exatamente, independentemente do fluxo normal. O elemento não participa do fluxo normal. As dimensões são relativas ao contêiner. No modo fixo, o contêiner é a janela de visualização.
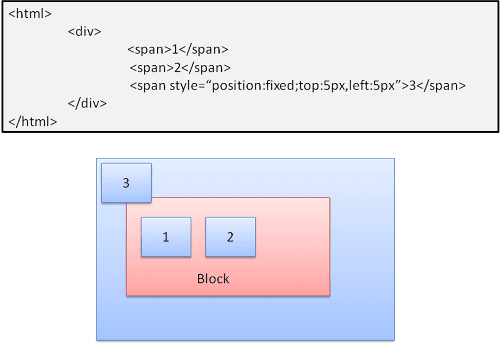
Representação em camadas
Isso é especificado pela propriedade CSS z-index. Ele representa a terceira dimensão da caixa: a posição ao longo do "eixo z".
As caixas são divididas em pilhas (chamadas de contextos de empilhamento). Em cada pilha, os elementos de trás serão pintados primeiro, e os da frente, por cima, mais perto do usuário. Em caso de sobreposição, o elemento mais à frente vai ocultar o anterior.
As pilhas são ordenadas de acordo com a propriedade z-index. As caixas com a propriedade "z-index" formam uma pilha local. A janela de visualização tem a pilha externa.
Exemplo:
<style type="text/css">
  div {
    position: absolute;
    left: 2in;
    top: 2in;
  }
</style>

<p>
  <div
    style="z-index: 3;background-color:red; width: 1in; height: 1in; ">
  </div>
  <div
    style="z-index: 1;background-color:green;width: 2in; height: 2in;">
  </div>
</p>
O resultado será este:

Embora a div vermelha preceda a verde na marcação e tenha sido pintada antes no fluxo normal, a propriedade z-index é maior, então ela está mais à frente na pilha mantida pela caixa raiz.
Recursos
Arquitetura do navegador
- Grosskurth, Alan. A Reference Architecture for Web Browsers (pdf)
- Gupta, Vineet. Como os navegadores funcionam - Parte 1 - Arquitetura
Análise
- Aho, Sethi, Ullman, Compilers: Principles, Techniques, and Tools (também conhecido como "Dragon book"), Addison-Wesley, 1986
- Rick Jelliffe. The Bold and the Beautiful: two new drafts for HTML 5.
Firefox
- L. David Baron, HTML e CSS mais rápidos: Layout Engine Internals para Desenvolvedores Web.
- L. David Baron, Faster HTML and CSS: Layout Engine Internals for Web Developers (vídeo de palestra técnica do Google)
- L. David Baron, Mozilla's Layout Engine
- L. David Baron, Mozilla Style System Documentation
- Chris Waterson, Notes on HTML Reflow (em inglês)
- Chris Waterson, Gecko Overview
- Alexander Larsson, A vida de uma solicitação HTTP HTML
WebKit
- David Hyatt, Implementing CSS(part 1)
- David Hyatt, An Overview of WebCore
- David Hyatt, WebCore Rendering
- David Hyatt, The FOUC Problem
Especificações do W3C
Instruções de criação de navegadores
Traduções
Esta página foi traduzida para o japonês duas vezes:
- How Browsers Work - Bastidores dos navegadores da web modernos (ja) por @kosei
- ブラウザってどうやって動いてるの?(モダンWEBブラウザシーンの裏側 por @ikeike443 e @kiyoto01.
Confira as traduções hospedadas externamente em coreano e turco.
Agradecemos a todos!