

Dowiedz się, czym jest skaner wstępnego wczytywania przeglądarki, jak pomaga zwiększyć wydajność i jak nie przeszkadzać mu w działaniu.
Jednym z często pomijanych aspektów optymalizacji Page Speed jest znajomość działania przeglądarki. Przeglądarki wprowadzają pewne optymalizacje, aby poprawić wydajność w sposób, którego my jako deweloperzy nie możemy zastosować – ale tylko wtedy, gdy te optymalizacje nie zostaną przypadkowo zakłócone.
Jedną z wewnętrznych optymalizacji przeglądarki, którą warto poznać, jest skaner wstępnego wczytywania. W tym poście wyjaśnimy, jak działa skaner wstępnego wczytywania, a co ważniejsze, jak nie przeszkadzać mu w pracy.
Czym jest skaner wstępnego wczytywania?
Każda przeglądarka ma główny parser HTML, który tokenizuje nieprzetworzone znaczniki i przetwarza je na model obiektowy. Wszystko to dzieje się do momentu, gdy parser zatrzyma się po znalezieniu zasobu blokującego, takiego jak arkusz stylów wczytany za pomocą elementu <link> lub skrypt wczytany za pomocą elementu <script> bez atrybutu async lub defer.

<link> zewnętrznego pliku CSS, który uniemożliwia przeglądarce przeanalizowanie pozostałej części dokumentu, a nawet wyrenderowanie jakiejkolwiek jego części, dopóki plik CSS nie zostanie pobrany i przeanalizowany.
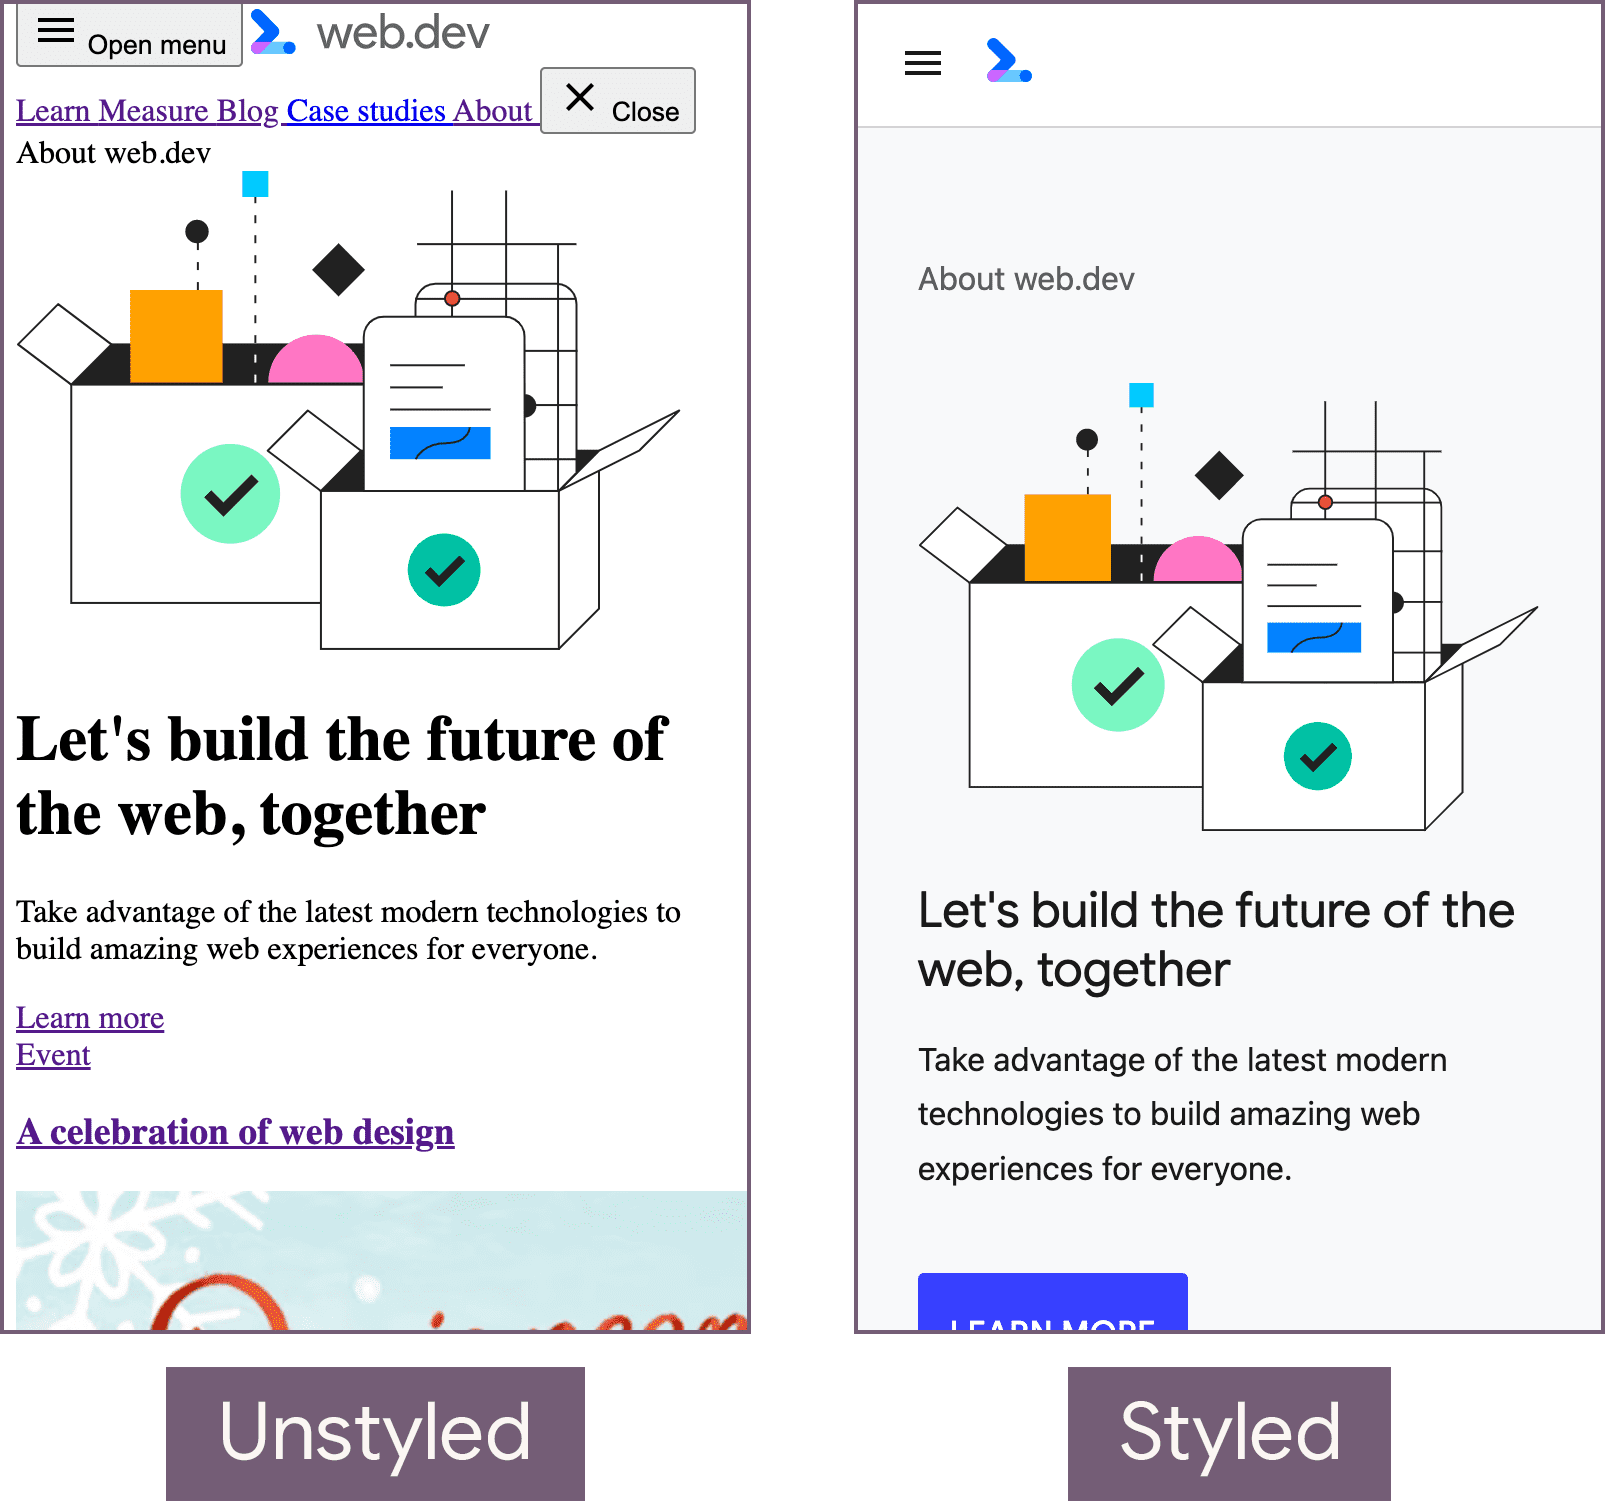
W przypadku plików CSS renderowanie jest blokowane, aby zapobiec mignięciu nieostylowanej treści (FOUC), czyli sytuacji, w której nieostylowana wersja strony jest widoczna przez chwilę, zanim zostaną do niej zastosowane style.
Przeglądarka blokuje też analizowanie i renderowanie strony, gdy napotka elementy <script> bez atrybutu defer lub async.
Dzieje się tak, ponieważ przeglądarka nie może mieć pewności, czy dany skrypt nie zmodyfikuje modelu DOM, gdy główny parser HTML będzie jeszcze wykonywał swoje zadanie. Dlatego powszechną praktyką jest wczytywanie kodu JavaScript na końcu dokumentu, aby skutki zablokowanego analizowania i renderowania były marginalne.
Są to dobre powody, dla których przeglądarka powinna blokować zarówno analizowanie, jak i renderowanie. Blokowanie tych ważnych kroków jest jednak niepożądane, ponieważ może opóźnić wykrywanie innych ważnych zasobów. Na szczęście przeglądarki starają się rozwiązać te problemy za pomocą dodatkowego parsera HTML, który nazywa się skanerem wstępnego wczytywania.
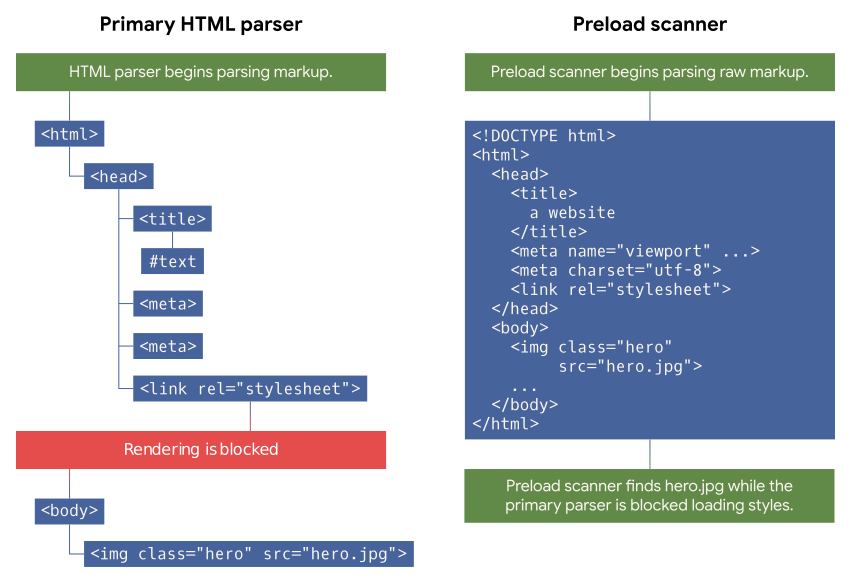
<body>. Skaner wstępnego wczytywania może jednak zajrzeć do nieprzetworzonych znaczników, aby znaleźć ten zasób obrazu i rozpocząć jego wczytywanie, zanim główny parser HTML zostanie odblokowany.
Skaner wstępnego wczytywania działa spekulacyjnie, co oznacza, że analizuje nieprzetworzone znaczniki, aby znaleźć zasoby do pobrania, zanim zostaną one wykryte przez główny parser HTML.
Jak sprawdzić, czy skaner wstępnego wczytywania działa
Skaner wstępnego wczytywania istnieje z powodu zablokowanego renderowania i analizowania. Gdyby te 2 problemy z wydajnością nie występowały, skaner wstępnego wczytywania nie byłby zbyt przydatny. To, czy strona internetowa korzysta ze skanera wstępnego wczytywania, zależy od tych zjawisk blokowania. Aby to zrobić, możesz wprowadzić sztuczne opóźnienie żądań, aby dowiedzieć się, gdzie działa skaner wstępnego wczytywania.
Weźmy na przykład tę stronę z podstawowym tekstem i obrazami oraz arkuszem stylów. Pliki CSS blokują zarówno renderowanie, jak i analizowanie, dlatego wprowadzasz sztuczne opóźnienie o 2 sekundy dla arkusza stylów za pomocą usługi pośredniczącej. To opóźnienie ułatwia sprawdzenie w wodospadzie sieci, gdzie działa skaner wstępnego wczytywania.
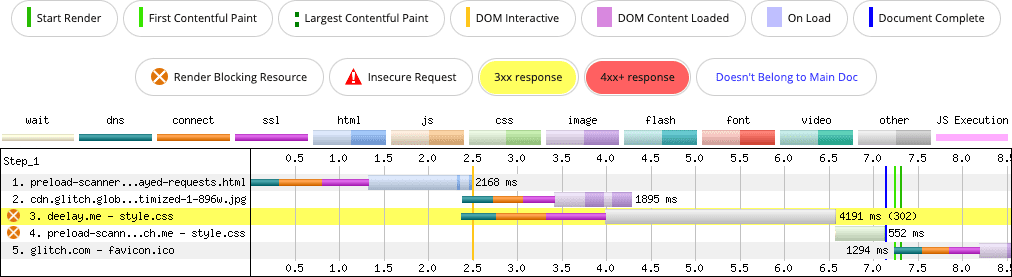
Jak widać na wykresie kaskadowym, skaner wstępnego wczytywania wykrywa element <img>, nawet gdy renderowanie i analizowanie dokumentu są zablokowane. Bez tej optymalizacji przeglądarka nie może pobierać zasobów w okresie blokowania, a więcej żądań zasobów będzie wysyłanych kolejno, a nie jednocześnie.
Po omówieniu tego prostego przykładu przyjrzyjmy się kilku rzeczywistym wzorcom, w których skaner wstępnego wczytywania może zostać pokonany, oraz temu, co można zrobić, aby je naprawić.
Wstrzyknięto skrypty async
Załóżmy, że w elemencie <head> masz kod HTML, który zawiera taki wbudowany kod JavaScript:
<script>
  const scriptEl = document.createElement('script');
  scriptEl.src = '/yall.min.js';

  document.head.appendChild(scriptEl);
</script>
Wstrzykiwane skrypty są domyślnie async, więc po wstrzyknięciu ten skrypt będzie zachowywał się tak, jakby zastosowano do niego atrybut async. Oznacza to, że zostanie on uruchomiony tak szybko, jak to możliwe, i nie będzie blokować renderowania. Brzmi optymalnie, prawda? Jeśli jednak założysz, że ten wbudowany element <script> występuje po elemencie <link>, który wczytuje zewnętrzny plik CSS, uzyskasz nieoptymalny wynik:

async. Skaner wstępnego wczytywania nie może wykryć skryptu podczas fazy blokowania renderowania, ponieważ jest on wstrzykiwany po stronie klienta.
Przeanalizujmy, co się stało:
- W sekundzie 0 wysyłane jest żądanie głównego dokumentu.
- W 1, 4 sekundzie dociera pierwszy bajt żądania nawigacji.
- W 2, 0 sekundzie następuje żądanie CSS i obrazu.
- Ponieważ parser jest blokowany podczas wczytywania arkusza stylów, a wbudowany kod JavaScript, który wstrzykuje skrypt
async, pojawia się po tym arkuszu stylów w 2,6 sekundy, funkcje, które zapewnia ten skrypt, nie są dostępne tak szybko, jak mogłyby być.
Jest to nieoptymalne, ponieważ żądanie skryptu następuje dopiero po zakończeniu pobierania arkusza stylów. Spowoduje to opóźnienie uruchomienia skryptu. Z kolei element <img> jest wykrywalny w znacznikach dostarczanych przez serwer, więc skaner wstępnego wczytywania go wykrywa.
Co się stanie, jeśli użyjesz zwykłego tagu <script> z atrybutem async, zamiast wstrzykiwać skrypt do modelu DOM?
<script src="/yall.min.js" async></script>
Oto wynik:

async <script>. Skaner wstępnego wczytywania wykrywa skrypt podczas fazy blokowania renderowania i wczytuje go jednocześnie z arkuszem CSS.
Może pojawić się pokusa, aby zasugerować, że te problemy można rozwiązać za pomocą rel=preload. To rozwiązanie na pewno by zadziałało, ale mogłoby mieć pewne skutki uboczne. Po co używać rel=preload do rozwiązywania problemu, którego można uniknąć, nie wstrzykując elementu <script> do DOM?
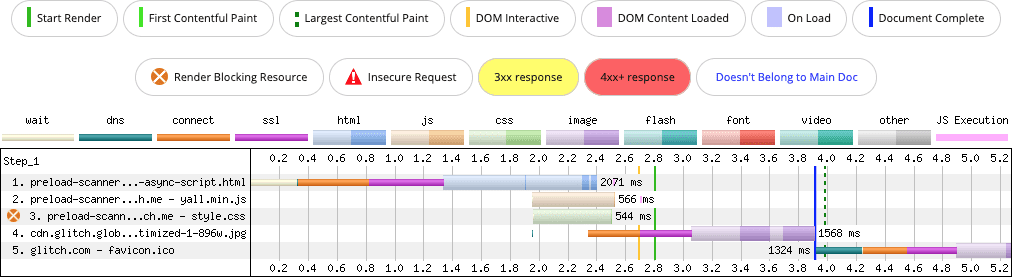
async, ale skrypt async jest wstępnie wczytywany, aby został wcześniej wykryty.
Wstępne wczytywanie „rozwiązuje” ten problem, ale wprowadza nowy: skrypt async w pierwszych 2 wersjach demonstracyjnych – mimo że jest wczytywany w <head> – jest wczytywany z priorytetem „Niski”, podczas gdy arkusz stylów jest wczytywany z priorytetem „Najwyższy”. W ostatniej wersji demonstracyjnej, w której skrypt async jest wstępnie wczytywany, arkusz stylów jest nadal wczytywany z priorytetem „Najwyższy”, ale priorytet skryptu został podniesiony do „Wysoki”.
Gdy priorytet zasobu zostanie podniesiony, przeglądarka przydzieli mu większą przepustowość. Oznacza to, że mimo iż arkusz stylów ma najwyższy priorytet, podwyższony priorytet skryptu może powodować rywalizację o przepustowość. Może to być istotne w przypadku wolnych połączeń lub gdy zasoby są dość duże.
Odpowiedź jest prosta: jeśli skrypt jest potrzebny podczas uruchamiania, nie omijaj skanera wstępnego wczytywania, wstrzykując go do DOM. Eksperymentuj z umieszczaniem elementu <script> oraz z atrybutami takimi jak defer i async.
Leniwe ładowanie za pomocą JavaScriptu
Leniwe ładowanie to świetna metoda oszczędzania danych, która jest często stosowana w przypadku obrazów. Czasami jednak leniwe ładowanie jest nieprawidłowo stosowane do obrazów, które znajdują się „nad częścią strony widoczną na ekranie”.
Może to powodować problemy z wykrywaniem zasobów przez skaner wstępnego wczytywania i niepotrzebnie opóźniać wykrywanie odniesienia do obrazu, pobieranie go, dekodowanie i wyświetlanie. Weźmy na przykład te znaczniki obrazu:
<img data-src="/sand-wasp.jpg" alt="Sand Wasp" width="384" height="255">
Użycie prefiksu data- jest powszechnym wzorcem w przypadku leniwego ładowania opartego na JavaScript. Gdy obraz zostanie przewinięty do widocznego obszaru, moduł leniwego ładowania usuwa prefiks data-, co oznacza, że w poprzednim przykładzie data-src staje się src. Ta aktualizacja powoduje, że przeglądarka pobiera zasób.
Ten wzorzec nie jest problematyczny, dopóki nie zostanie zastosowany do obrazów, które znajdują się w widocznym obszarze podczas uruchamiania. Skaner wstępnego wczytywania nie odczytuje atrybutu data-src w taki sam sposób jak atrybutu src (lub srcset), więc odwołanie do obrazu nie jest wykrywane wcześniej. Co gorsza, obraz jest wczytywany dopiero po pobraniu, skompilowaniu i wykonaniu kodu JavaScript leniwego ładowania.

W zależności od rozmiaru obrazu, który może zależeć od rozmiaru widocznego obszaru, może on być elementem kandydującym do największego wyrenderowania treści (LCP). Gdy skaner wstępnego wczytywania nie może pobrać zasobu obrazu z wyprzedzeniem(np. gdy arkusze stylów strony blokują renderowanie), LCP ulega pogorszeniu.
Rozwiązaniem jest zmiana znaczników obrazu:
<img src="/sand-wasp.jpg" alt="Sand Wasp" width="384" height="255">
To optymalny wzorzec dla obrazów, które znajdują się w widocznym obszarze podczas uruchamiania, ponieważ skaner wstępnego wczytywania szybciej wykryje i pobierze zasób obrazu.
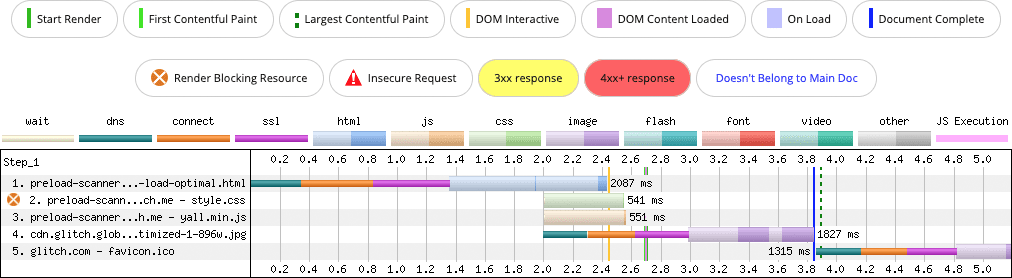
W tym uproszczonym przykładzie wynik to poprawa wskaźnika LCP o 100 milisekund przy wolnym połączeniu. Może się wydawać, że to niewielka poprawa, ale jeśli weźmiesz pod uwagę, że rozwiązanie polega na szybkiej poprawce znaczników i że większość stron internetowych jest bardziej złożona niż ten zestaw przykładów, to jest to duża zmiana. Oznacza to, że kandydaci na LCP mogą konkurować o przepustowość z wieloma innymi zasobami, dlatego optymalizacje takie jak ta stają się coraz ważniejsze.
obrazy tła CSS,
Pamiętaj, że skaner wstępnego wczytywania przeglądarki skanuje znaczniki. Nie skanuje innych typów zasobów, takich jak CSS, które mogą obejmować pobieranie obrazów, do których odwołuje się właściwość background-image.
Podobnie jak w przypadku HTML przeglądarki przetwarzają CSS na własny model obiektowy, znany jako CSSOM. Jeśli podczas tworzenia CSSOM zostaną wykryte zasoby zewnętrzne, żądania dotyczące tych zasobów są wysyłane w momencie ich wykrycia, a nie przez skaner wstępnego wczytywania.
Załóżmy, że kandydatem do LCP na Twojej stronie jest element z właściwością CSS background-image. Podczas wczytywania zasobów:
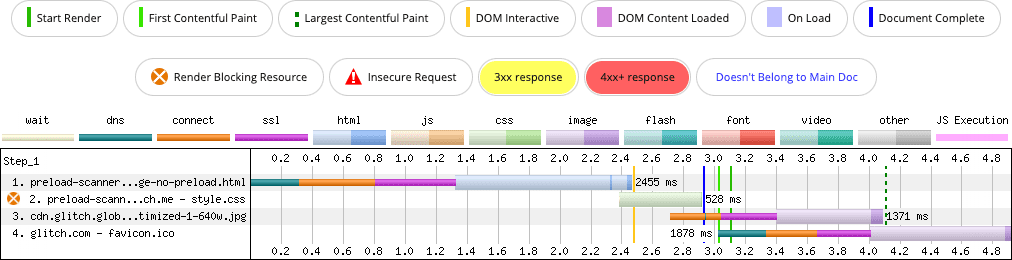
background-image (wiersz 3). Pobieranie żądanego obrazu rozpoczyna się dopiero wtedy, gdy parser CSS go znajdzie.
W takim przypadku skaner wstępnego wczytywania nie jest tak bardzo nieskuteczny, jak niezaangażowany. Jeśli jednak kandydat na LCP na stronie pochodzi z właściwości CSS background-image, warto wstępnie załadować ten obraz:
<!-- Make sure this is in the <head> below any
     stylesheets, so as not to block them from loading -->
<link rel="preload" as="image" href="lcp-image.jpg">
Ta wskazówka rel=preload jest niewielka, ale pomaga przeglądarce szybciej odkryć obraz:

background-image (wiersz 3). Wskazówka rel=preload pomaga przeglądarce wykryć obraz o około 250 milisekund szybciej niż bez wskazówki.
Dzięki wskazówce rel=preload kandydat LCP jest wykrywany wcześniej, co skraca czas LCP. Ta wskazówka pomaga rozwiązać problem, ale lepszym rozwiązaniem może być ocena, czy obraz kandydujący do LCP musi być wczytywany z CSS. Tag <img> daje większą kontrolę nad wczytywaniem obrazu odpowiedniego dla widocznego obszaru, a jednocześnie umożliwia skanerowi wstępnego wczytywania jego wykrycie.
Wstawianie zbyt wielu zasobów w kodzie
Wstawianie w kodzie to praktyka polegająca na umieszczaniu zasobu w kodzie HTML. Arkusze stylów możesz umieszczać w elementach <style>, skrypty w elementach <script>, a praktycznie każdy inny zasób – za pomocą kodowania base64.
Wstawianie zasobów może być szybsze niż ich pobieranie, ponieważ nie jest wysyłane osobne żądanie dotyczące zasobu. Jest on dostępny bezpośrednio w dokumencie i wczytuje się natychmiast. Ma jednak istotne wady:
- Jeśli nie buforujesz kodu HTML (a nie możesz tego zrobić, jeśli odpowiedź HTML jest dynamiczna), zasoby wbudowane nigdy nie są buforowane. Wpływa to na wydajność, ponieważ zasobów wbudowanych nie można używać ponownie.
- Nawet jeśli możesz zapisać kod HTML w pamięci podręcznej, zasoby wbudowane nie są udostępniane między dokumentami. Zmniejsza to wydajność buforowania w porównaniu z plikami zewnętrznymi, które można buforować i ponownie wykorzystywać w całym źródle.
- Jeśli umieścisz zbyt wiele elementów w kodzie, opóźnisz wykrywanie zasobów przez skaner wstępnego wczytywania w dalszej części dokumentu, ponieważ pobieranie dodatkowych treści umieszczonych w kodzie zajmie więcej czasu.
Weźmy na przykład tę stronę. W pewnych warunkach kandydatem do LCP jest obraz u góry strony, a kod CSS znajduje się w osobnym pliku wczytywanym przez element <link>. Strona używa też 4 czcionek internetowych, które są żądane jako osobne pliki z zasobu CSS.
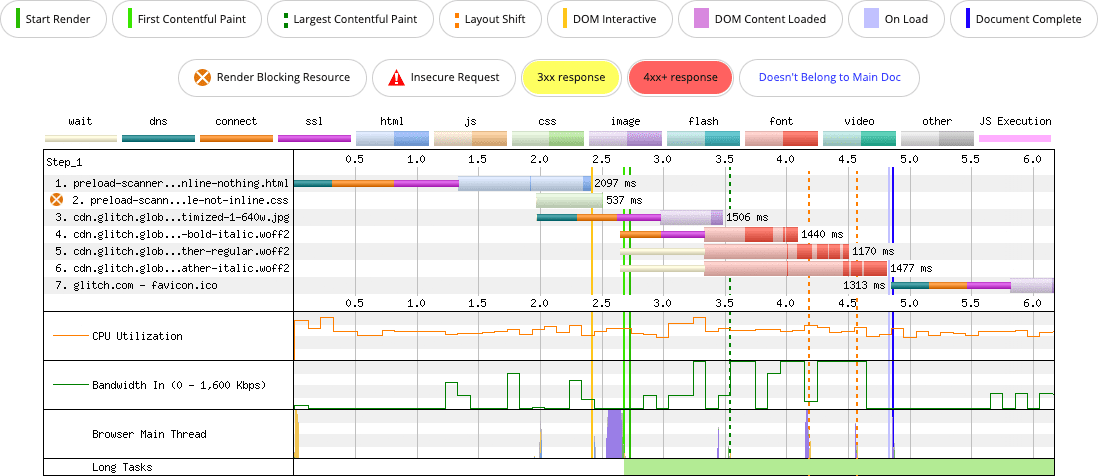
<img>, ale został on wykryty przez skaner wstępnego wczytywania, ponieważ arkusze CSS i czcionki wymagane do wczytania strony są wczytywane w osobnych zasobach, co nie opóźnia działania skanera wstępnego wczytywania.
Co się stanie, jeśli CSS i wszystkie czcionki zostaną wbudowane jako zasoby base64?

<img>, ale umieszczenie kodu CSS i jego 4 zasobów czcionek w elemencie `` opóźnia wykrycie obrazu przez skaner wstępnego wczytywania do momentu, aż te zasoby zostaną w pełni pobrane.
W tym przykładzie wstawianie kodu w tekście ma negatywny wpływ na LCP i ogólną wydajność. Wersja strony, która nie zawiera żadnych elementów wbudowanych, renderuje obraz LCP w około 3,5 sekundy. Strona, która zawiera wszystko w kodzie, nie renderuje obrazu LCP przez nieco ponad 7 sekund.
W tym przypadku chodzi o coś więcej niż tylko skaner wstępnego wczytywania. Wstawianie czcionek w kodzie nie jest dobrą strategią, ponieważ base64 jest nieefektywnym formatem zasobów binarnych. Innym czynnikiem jest to, że zewnętrzne zasoby czcionek nie są pobierane, chyba że CSSOM uzna je za niezbędne. Gdy te czcionki są wstawiane jako base64, są pobierane niezależnie od tego, czy są potrzebne na bieżącej stronie.
Czy wstępne wczytywanie może poprawić sytuację? Jasne. Możesz wstępnie wczytać obraz LCP i skrócić czas LCP, ale przeładowanie kodu HTML, który może nie być możliwy do zapisania w pamięci podręcznej, zasobami wbudowanymi ma inne negatywne konsekwencje dla wydajności. Ten wzorzec ma też wpływ na pierwsze wyrenderowanie treści (FCP). W wersji strony, na której nic nie jest wstawione, FCP wynosi około 2,7 sekundy. W wersji, w której wszystko jest wstawione, FCP wynosi około 5,8 sekundy.
Zachowaj szczególną ostrożność podczas wstawiania elementów do kodu HTML, zwłaszcza zasobów zakodowanych w formacie base64. Zwykle nie jest to zalecane, z wyjątkiem bardzo małych zasobów. Wstawiaj jak najmniej, ponieważ zbyt wiele wstawień to igranie z ogniem.
Renderowanie znaczników za pomocą kodu JavaScript po stronie klienta
Nie ma wątpliwości, że JavaScript wpływa na szybkość strony. Deweloperzy nie tylko polegają na nim, aby zapewnić interaktywność, ale też mają tendencję do polegania na nim w celu dostarczania samych treści. W pewnym sensie ułatwia to pracę deweloperom, ale korzyści dla deweloperów nie zawsze przekładają się na korzyści dla użytkowników.
Jednym ze wzorców, który może uniemożliwić działanie skanera wstępnego wczytywania, jest renderowanie znaczników za pomocą kodu JavaScript po stronie klienta:

Gdy ładunki znaczników są zawarte w kodzie JavaScript i renderowane w całości przez ten kod w przeglądarce, wszystkie zasoby w tych znacznikach są niewidoczne dla skanera wstępnego wczytywania. Opóźnia to wykrywanie ważnych zasobów, co z pewnością wpływa na LCP. W tych przykładach żądanie obrazu LCP jest znacznie opóźnione w porównaniu z odpowiednikiem renderowanym po stronie serwera, który nie wymaga JavaScriptu.
To nieco odbiega od tematu tego artykułu, ale efekty renderowania znaczników na kliencie wykraczają daleko poza ominięcie skanera wstępnego wczytywania. Po pierwsze, wprowadzenie JavaScriptu do obsługi funkcji, która go nie wymaga, powoduje niepotrzebne wydłużenie czasu przetwarzania, co może mieć wpływ na interakcję do kolejnego wyrenderowania (INP). Renderowanie bardzo dużych ilości znaczników po stronie klienta może generować długie zadania w porównaniu z tą samą ilością znaczników wysyłanych przez serwer. Powodem tego – oprócz dodatkowego przetwarzania, którego wymaga JavaScript – jest to, że przeglądarki przesyłają znaczniki z serwera i dzielą renderowanie na fragmenty w taki sposób, że zwykle ogranicza to długie zadania. Z kolei znaczniki renderowane po stronie klienta są obsługiwane jako pojedyncze, monolityczne zadanie, co może mieć wpływ na INP strony.
Rozwiązanie w tym przypadku zależy od odpowiedzi na pytanie: czy istnieje powód, dla którego znaczniki strony nie mogą być dostarczane przez serwer, tylko muszą być renderowane po stronie klienta? Jeśli odpowiedź brzmi „nie”, należy rozważyć renderowanie po stronie serwera (SSR) lub statycznie generowane znaczniki, ponieważ pomoże to skanerowi wstępnego wczytywania wykryć i pobrać ważne zasoby z wyprzedzeniem.
Jeśli Twoja strona potrzebuje JavaScriptu, aby dodać funkcje do niektórych części znaczników, możesz to zrobić za pomocą SSR, używając czystego JavaScriptu lub hydratacji, aby uzyskać najlepsze rezultaty.
Pomóż skanerowi wstępnego wczytywania pomóc Tobie
Skaner wstępnego wczytywania to bardzo skuteczna optymalizacja przeglądarki, która pomaga szybciej wczytywać strony podczas uruchamiania. Unikając wzorców, które uniemożliwiają wcześniejsze wykrywanie ważnych zasobów, nie tylko ułatwiasz sobie programowanie, ale też tworzysz lepsze wrażenia użytkowników, co przełoży się na lepsze wyniki w przypadku wielu wskaźników, w tym niektórych Web Vitals.
Podsumowując, oto najważniejsze informacje z tego posta:
- Skaner wstępnego wczytywania przeglądarki to dodatkowy parser HTML, który skanuje przed głównym, jeśli jest on zablokowany, aby wykryć zasoby, które można pobrać wcześniej.
- Skaner wstępnego wczytywania nie może wykryć zasobów, które nie są obecne w znacznikach dostarczonych przez serwer w początkowym żądaniu nawigacji. Skaner wstępnego wczytywania może zostać pominięty m.in. w tych przypadkach:
- Wstrzykiwanie zasobów do DOM za pomocą JavaScriptu, niezależnie od tego, czy są to skrypty, obrazy, arkusze stylów czy inne elementy, które lepiej byłoby umieścić w początkowym ładunku znaczników z serwera.
- Leniwe ładowanie obrazów lub elementów iframe w części strony widocznej na ekranie za pomocą rozwiązania JavaScript.
- renderowanie znaczników na kliencie, które mogą zawierać odwołania do zasobów podrzędnych dokumentu, za pomocą JavaScriptu;
- Skaner wstępnego wczytywania skanuje tylko kod HTML. Nie sprawdza zawartości innych zasobów, zwłaszcza CSS, które mogą zawierać odniesienia do ważnych zasobów, w tym kandydatów do LCP.
Jeśli z jakiegoś powodu nie możesz uniknąć wzorca, który negatywnie wpływa na zdolność skanera wstępnego wczytywania do przyspieszania ładowania, rozważ użycie wskazówki dotyczącej zasobów rel=preload. Jeśli używasz rel=preload, przetestuj tę funkcję w narzędziach laboratoryjnych, aby upewnić się, że działa zgodnie z oczekiwaniami. Nie wczytuj wstępnie zbyt wielu zasobów, ponieważ jeśli nadasz priorytet wszystkim, żaden nie będzie go miał.
Zasoby
- Szkodliwe „skrypty asynchroniczne” wstawiane przez skrypt
- Jak wstępne wczytywanie w przeglądarce przyspiesza wczytywanie stron
- Wstępne wczytywanie kluczowych zasobów w celu zwiększenia szybkości ładowania
- Wcześniejsze nawiązywanie połączeń sieciowych w celu zwiększenia postrzeganej szybkości strony
- Optymalizacja największego wyrenderowania treści