

Saiba o que é o scanner de pré-carregamento do navegador, como ele ajuda na performance e como não atrapalhar o funcionamento dele.
Um aspecto negligenciado da otimização da velocidade de página envolve conhecer um pouco sobre os componentes internos do navegador. Os navegadores fazem certas otimizações para melhorar o desempenho de maneiras que nós, como desenvolvedores, não podemos, mas apenas se essas otimizações não forem frustradas sem querer.
Uma otimização interna do navegador que você precisa entender é o scanner de pré-carregamento do navegador. Nesta postagem, vamos falar sobre como o scanner de pré-carregamento funciona e, mais importante, como evitar que ele seja atrapalhado.
O que é um scanner de pré-carregamento?
Todo navegador tem um analisador HTML principal que tokeniza a marcação bruta e a processa em um modelo de objeto. Isso tudo continua até que o analisador seja pausado ao encontrar um recurso de bloqueio, como uma folha de estilo carregada com um elemento <link> ou um script carregado com um elemento <script> sem um atributo async ou defer.
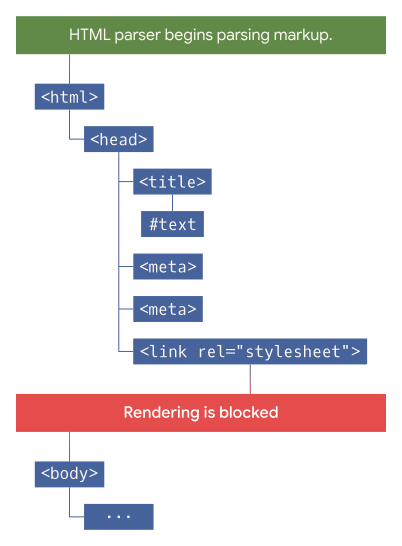
<link> para um arquivo CSS externo, o que impede o navegador de analisar o restante do documento ou até mesmo de renderizar qualquer parte dele até que o CSS seja baixado e analisado.
No caso de arquivos CSS, a renderização é bloqueada para evitar um flash de conteúdo sem estilo (FOUC, na sigla em inglês), que é quando uma versão sem estilo de uma página pode ser vista brevemente antes que os estilos sejam aplicados a ela.
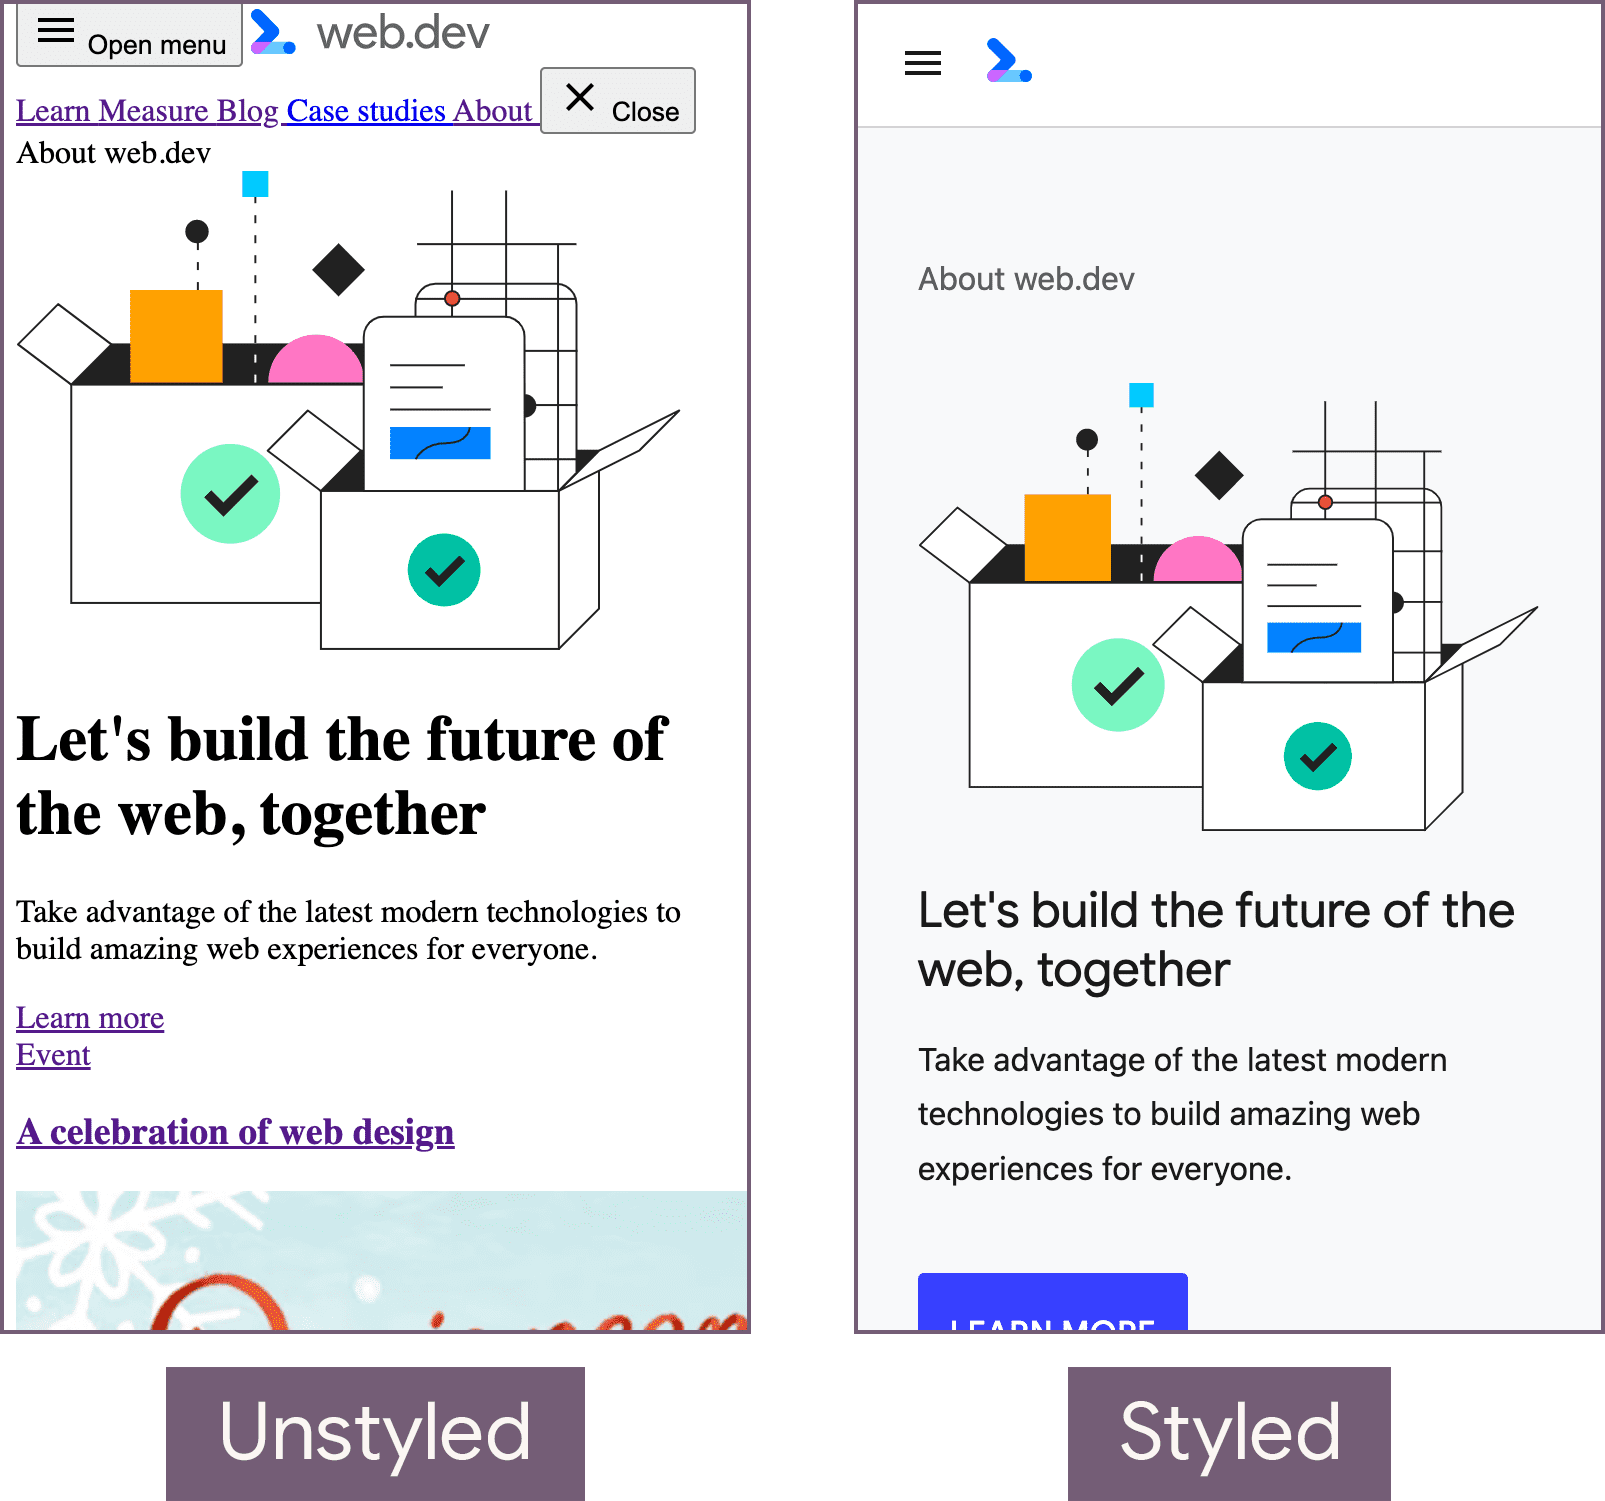
O navegador também bloqueia a análise e a renderização da página quando encontra elementos <script> sem um atributo defer ou async.
Isso ocorre porque o navegador não tem como saber se um determinado script vai modificar o DOM enquanto o analisador de HTML principal ainda está fazendo o trabalho dele. Por isso, é comum carregar o JavaScript no final do documento para que os efeitos da análise e da renderização bloqueadas sejam marginais.
Esses são bons motivos para o navegador bloquear tanto a análise quanto a renderização. No entanto, bloquear qualquer uma dessas etapas importantes é indesejável, porque pode atrasar a descoberta de outros recursos importantes. Felizmente, os navegadores fazem o possível para mitigar esses problemas usando um analisador HTML secundário chamado scanner de pré-carregamento.
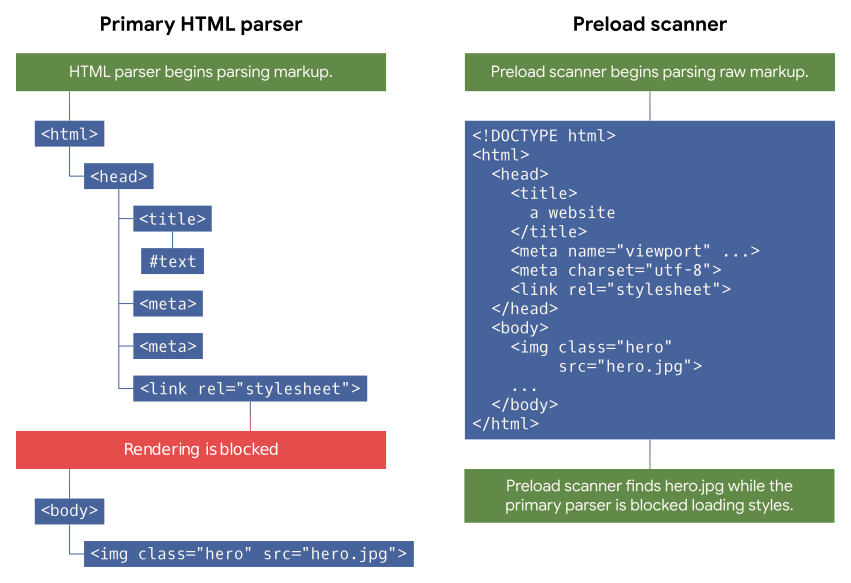
<body>. No entanto, o scanner de pré-carregamento pode analisar a marcação bruta para encontrar esse recurso de imagem e começar a carregá-lo antes que o analisador HTML principal seja desbloqueado.
A função de um scanner de pré-carregamento é especulativa, ou seja, ele examina a marcação bruta para encontrar recursos que podem ser buscados antes que o analisador HTML principal os descubra.
Como saber quando o scanner de pré-carregamento está funcionando
O scanner de pré-carregamento existe devido à renderização e à análise bloqueadas. Se esses dois problemas de desempenho nunca existissem, o scanner de pré-carregamento não seria muito útil. A chave para descobrir se uma página da Web se beneficia do scanner de pré-carregamento depende desses fenômenos de bloqueio. Para fazer isso, introduza um atraso artificial nas solicitações para descobrir onde o scanner de pré-carregamento está funcionando.
Veja esta página de texto e imagens básicos com uma folha de estilo como exemplo. Como os arquivos CSS bloqueiam a renderização e a análise, você introduz um atraso artificial de dois segundos para a folha de estilo usando um serviço de proxy. Esse atraso facilita a visualização do local em que o scanner de pré-carregamento está funcionando na cascata de rede.
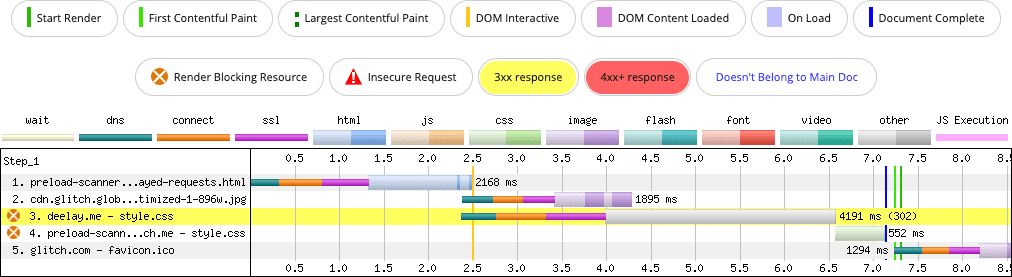
Como você pode ver na cascata, o scanner de pré-carregamento descobre o elemento <img> mesmo enquanto a renderização e a análise do documento estão bloqueadas. Sem essa otimização, o navegador não pode buscar itens de forma oportunista durante o período de bloqueio, e mais solicitações de recursos seriam consecutivas, em vez de simultâneas.
Agora que já mostramos esse exemplo simples, vamos analisar alguns padrões reais em que o scanner de pré-carregamento pode ser derrotado e o que pode ser feito para corrigir isso.
Scripts async injetados
Digamos que você tenha HTML no seu <head> que inclua um JavaScript inline como este:
<script>
  const scriptEl = document.createElement('script');
  scriptEl.src = '/yall.min.js';

  document.head.appendChild(scriptEl);
</script>
Os scripts injetados são async por padrão. Portanto, quando esse script é injetado, ele se comporta como se o atributo async tivesse sido aplicado a ele. Isso significa que ele será executado assim que possível e não vai bloquear a renderização. Parece ótimo, certo? No entanto, se você presumir que esse <script> inline vem depois de um elemento <link> que carrega um arquivo CSS externo, o resultado não será o ideal:
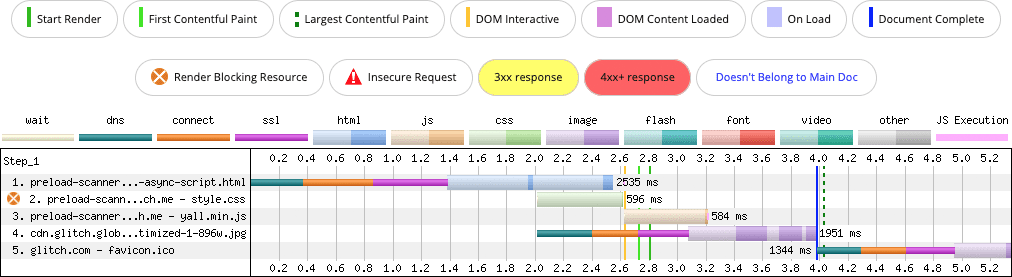
async injetado. O scanner de pré-carregamento não consegue descobrir o script durante a fase de bloqueio de renderização porque ele é injetado no cliente.
Vamos analisar o que aconteceu:
- Em 0 segundo, o documento principal é solicitado.
- Em 1,4 segundo, o primeiro byte da solicitação de navegação chega.
- Em 2 segundos, o CSS e a imagem são solicitados.
- Como o analisador é bloqueado ao carregar a folha de estilo, e o JavaScript inline que injeta o script
asyncvem depois dessa folha de estilo em 2,6 segundos, a funcionalidade que o script oferece não fica disponível o mais rápido possível.
Isso não é o ideal, porque a solicitação do script só ocorre depois que o download da folha de estilo é concluído. Isso atrasa a execução do script o mais rápido possível. Por outro lado, como o elemento <img> é detectável na marcação fornecida pelo servidor, ele é descoberto pelo scanner de pré-carregamento.
Então, o que acontece se você usar uma tag <script> comum com o atributo async em vez de injetar o script no DOM?
<script src="/yall.min.js" async></script>
Este é o resultado:
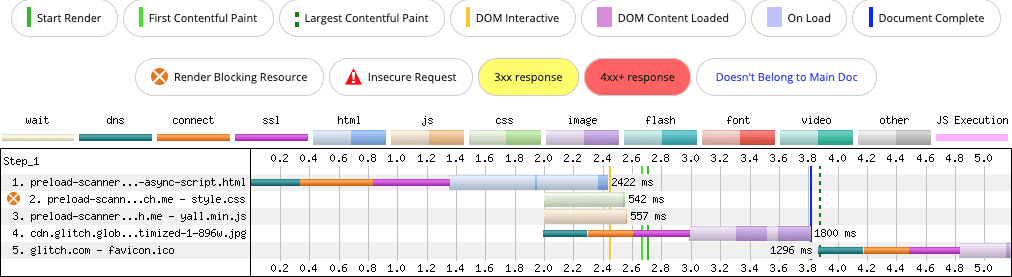
async <script>. O verificador de pré-carregamento descobre o script durante a fase de bloqueio de renderização e o carrega simultaneamente com o CSS.
Pode ser tentador sugerir que esses problemas poderiam ser resolvidos usando rel=preload. Isso certamente funcionaria, mas pode ter alguns efeitos colaterais. Afinal, por que usar rel=preload para corrigir um problema que pode ser evitado não injetando um elemento <script> no DOM?
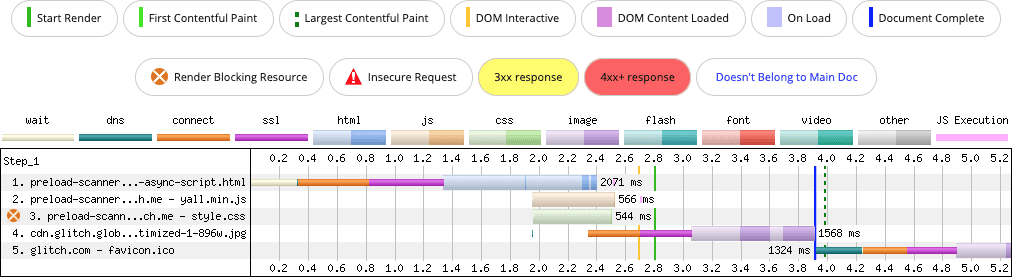
async injetado, mas o script async é pré-carregado para garantir que seja descoberto mais cedo.
O pré-carregamento "corrige" o problema aqui, mas introduz um novo: o script async nas duas primeiras demonstrações, apesar de ser carregado no <head>, é carregado com prioridade "Baixa", enquanto a folha de estilo é carregada com prioridade "Mais alta". Na última demonstração, em que o script async é pré-carregado, a folha de estilo ainda é carregada com a prioridade "Mais alta", mas a prioridade do script foi promovida para "Alta".
Quando a prioridade de um recurso é aumentada, o navegador aloca mais largura de banda para ele. Isso significa que, mesmo que a folha de estilo tenha a prioridade mais alta, a prioridade elevada do script pode causar contenção de largura de banda. Isso pode ser um fator em conexões lentas ou em casos em que os recursos são muito grandes.
A resposta aqui é simples: se um script for necessário durante a inicialização, não injete-o no DOM para não prejudicar o scanner de pré-carregamento. Faça testes conforme necessário com o posicionamento do elemento <script> e com atributos como defer e async.
Carregamento lento com JavaScript
O carregamento lento é um ótimo método para conservar dados, geralmente aplicado a imagens. No entanto, às vezes o carregamento lento é aplicado incorretamente a imagens que estão "acima da dobra", por assim dizer.
Isso gera possíveis problemas com a facilidade de descoberta de recursos no que diz respeito ao scanner de pré-carregamento e pode atrasar desnecessariamente o tempo necessário para descobrir uma referência a uma imagem, fazer o download, decodificar e apresentar. Por exemplo, considere esta marcação de imagem:
<img data-src="/sand-wasp.jpg" alt="Sand Wasp" width="384" height="255">
O uso de um prefixo data- é um padrão comum em carregadores lentos com tecnologia JavaScript. Quando a imagem é rolada para a janela de visualização, o carregador lento remove o prefixo data-, o que significa que, no exemplo anterior, data-src se torna src. Essa atualização solicita que o navegador busque o recurso.
Esse padrão não é problemático até ser aplicado a imagens que estão na janela de visualização durante a inicialização. Como o scanner de pré-carregamento não lê o atributo data-src da mesma forma que um atributo src (ou srcset), a referência da imagem não é descoberta antes. Pior ainda, o carregamento da imagem é atrasado até depois que o JavaScript do carregador lento é baixado, compilado e executado.
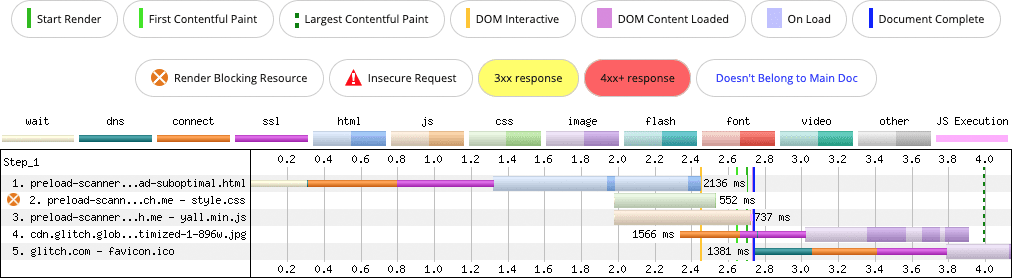
Dependendo do tamanho da imagem, que pode depender do tamanho da janela de visualização, ela pode ser um elemento candidato para a Largest Contentful Paint (LCP). Quando o scanner de pré-carregamento não consegue buscar o recurso de imagem de forma especulativa com antecedência, possivelmente durante o momento em que as folhas de estilo da página bloqueiam a renderização, a LCP é afetada.
A solução é mudar a marcação da imagem:
<img src="/sand-wasp.jpg" alt="Sand Wasp" width="384" height="255">
Esse é o padrão ideal para imagens que estão na janela de visualização durante a inicialização, já que o scanner de pré-carregamento vai descobrir e buscar o recurso de imagem mais rapidamente.
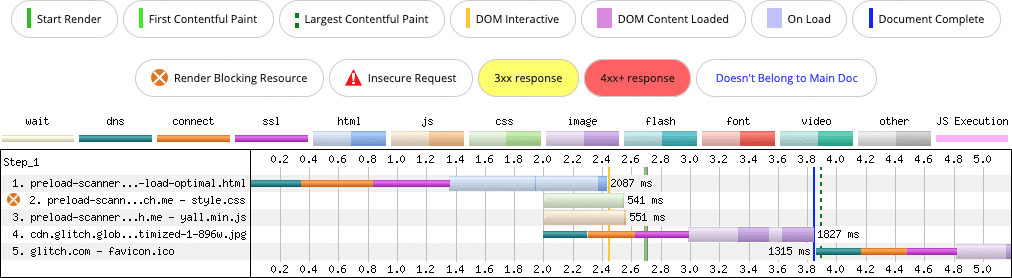
O resultado neste exemplo simplificado é uma melhoria de 100 milissegundos na LCP em uma conexão lenta. Isso pode não parecer uma grande melhoria, mas é quando você considera que a solução é uma correção rápida de marcação e que a maioria das páginas da Web é mais complexa do que esse conjunto de exemplos. Isso significa que os candidatos à LCP podem ter que disputar a largura de banda com muitos outros recursos, então otimizações como essa se tornam cada vez mais importantes.
Imagens de plano de fundo CSS
O scanner de pré-carregamento do navegador verifica a marcação. Ele não verifica outros tipos de recursos, como CSS, que podem envolver buscas de imagens referenciadas pela propriedade background-image.
Assim como o HTML, os navegadores processam o CSS em um modelo de objeto próprio, conhecido como CSSOM. Se recursos externos forem descobertos durante a construção do CSSOM, eles serão solicitados no momento da descoberta, e não pelo scanner de pré-carregamento.
Digamos que o candidato à LCP da sua página seja um elemento com uma propriedade CSS background-image. Veja o que acontece quando os recursos são carregados:
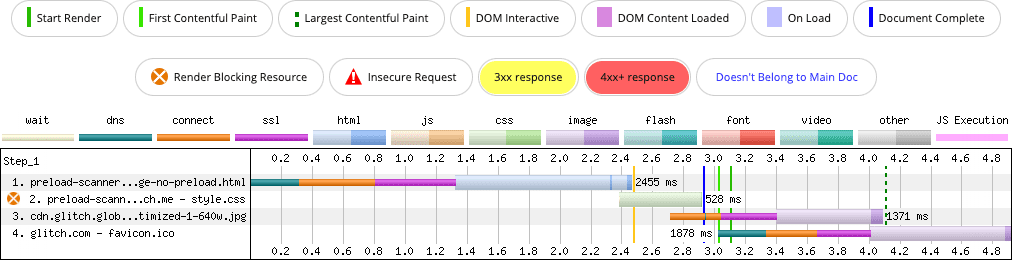
background-image (linha 3). A imagem solicitada só começa a ser buscada quando o analisador de CSS a encontra.
Nesse caso, o scanner de pré-carregamento não é derrotado, mas não está envolvido. Mesmo assim, se um candidato a LCP na página for de uma propriedade CSS background-image, será necessário pré-carregar essa imagem:
<!-- Make sure this is in the <head> below any
     stylesheets, so as not to block them from loading -->
<link rel="preload" as="image" href="lcp-image.jpg">
Essa dica rel=preload é pequena, mas ajuda o navegador a descobrir a imagem antes do que faria de outra forma:
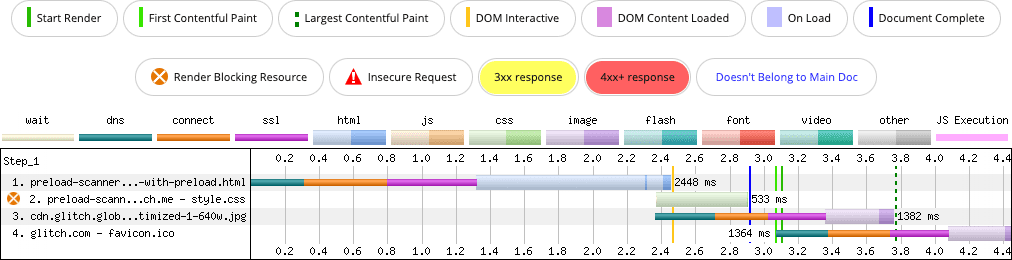
background-image (linha 3). A dica rel=preload ajuda o navegador a descobrir a imagem cerca de 250 milissegundos antes do que sem a dica.
Com a dica rel=preload, o candidato à LCP é descoberto mais cedo, reduzindo o tempo de LCP. Embora essa dica ajude a corrigir o problema, a melhor opção pode ser avaliar se o candidato a LCP de imagem precisa ser carregado do CSS. Com uma tag <img>, você tem mais controle sobre o carregamento de uma imagem adequada para a janela de visualização, permitindo que o scanner de pré-carregamento a descubra.
Inlining de muitos recursos
A incorporação é uma prática que coloca um recurso dentro do HTML. É possível incorporar folhas de estilo em elementos <style>, scripts em elementos <script> e praticamente qualquer outro recurso usando a codificação base64.
A incorporação de recursos pode ser mais rápida do que o download deles, porque não é emitida uma solicitação separada para o recurso. Ele está no documento e é carregado instantaneamente. No entanto, há desvantagens significativas:
- Se você não estiver armazenando o HTML em cache (e não é possível fazer isso se a resposta HTML for dinâmica), os recursos inline nunca serão armazenados em cache. Isso afeta o desempenho porque os recursos inline não são reutilizáveis.
- Mesmo que você possa armazenar HTML em cache, os recursos inline não são compartilhados entre documentos. Isso reduz a eficiência do armazenamento em cache em comparação com arquivos externos que podem ser armazenados em cache e reutilizados em uma origem inteira.
- Se você fizer isso em excesso, vai atrasar a descoberta de recursos pelo scanner de pré-carregamento mais adiante no documento, porque o download desse conteúdo extra vai demorar mais.
Veja esta página como exemplo. Em determinadas condições, o candidato à LCP é a imagem na parte de cima da página, e o CSS está em um arquivo separado carregado por um elemento <link>. A página também usa quatro fontes da Web que são solicitadas como arquivos separados do recurso CSS.
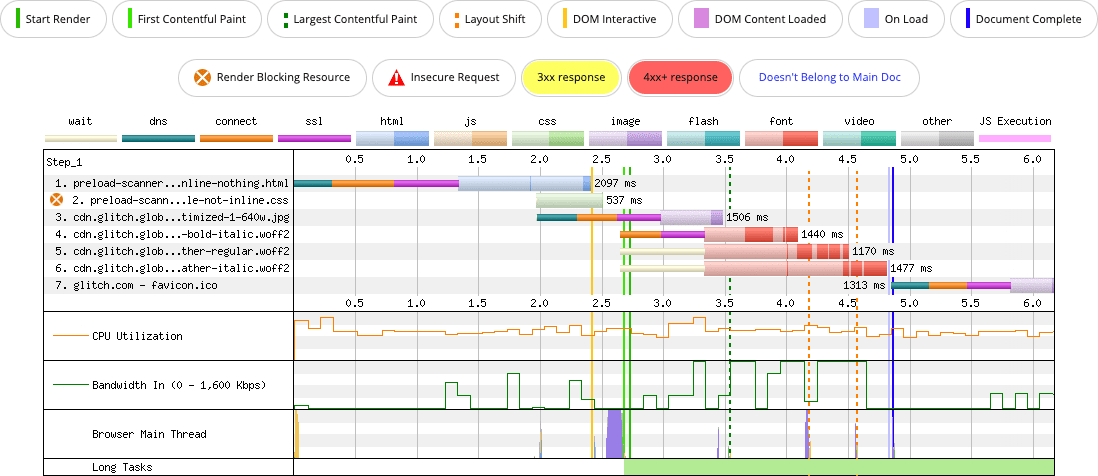
<img>, mas é descoberto pelo scanner de pré-carregamento porque o CSS e as fontes necessárias para o carregamento de página são carregados em recursos separados, o que não atrasa o trabalho do scanner de pré-carregamento.
Agora, o que acontece se o CSS e todas as fontes forem inline como recursos base64?
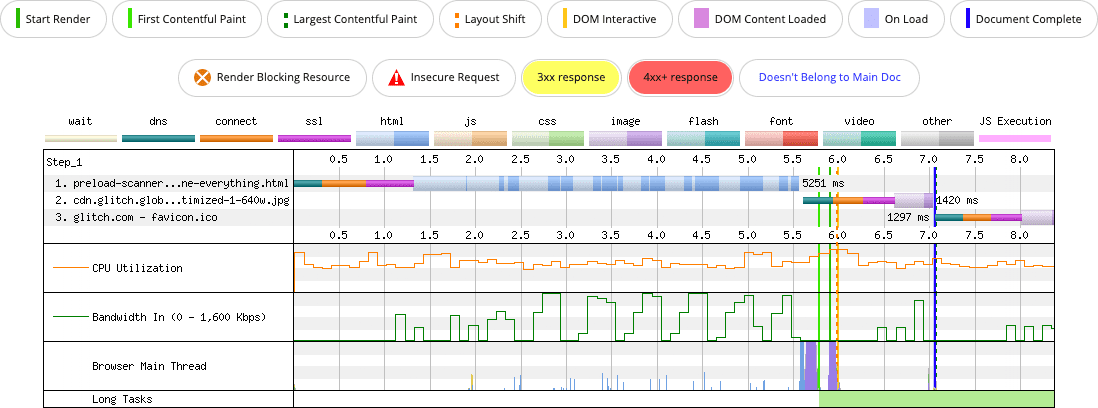
<img>, mas o CSS inline e os quatro recursos de fonte no `` atrasam o scanner de pré-carregamento, que só descobre a imagem quando esses recursos são totalmente baixados.
O impacto do inline gera consequências negativas para a LCP neste exemplo e para o desempenho em geral. A versão da página que não inclui nada inline pinta a imagem da LCP em cerca de 3,5 segundos. A página que incorpora tudo não pinta a imagem da LCP até pouco mais de 7 segundos.
Há mais em jogo aqui do que apenas o scanner de pré-carregamento. A incorporação de fontes não é uma boa estratégia porque o base64 é um formato ineficiente para recursos binários. Outro fator em jogo é que os recursos de fontes externas não são baixados, a menos que sejam determinados como necessários pelo CSSOM. Quando essas fontes são inline como base64, elas são baixadas, sejam necessárias para a página atual ou não.
Um pré-carregamento poderia melhorar as coisas aqui? Claro. Você pode pré-carregar a imagem da LCP e reduzir o tempo dela, mas aumentar o HTML potencialmente não armazenável em cache com recursos inline tem outras consequências negativas para o desempenho. A First Contentful Paint (FCP) também é afetada por esse padrão. Na versão da página em que nada é inline, a FCP é de aproximadamente 2,7 segundos. Na versão em que tudo está inline, a FCP é de aproximadamente 5,8 segundos.
Tenha muito cuidado ao incorporar elementos no HTML, especialmente recursos codificados em base64. Em geral, isso não é recomendado, exceto para recursos muito pequenos. Use o mínimo possível de inlining, porque o excesso pode causar problemas.
Como renderizar marcação com JavaScript do lado do cliente
Não há dúvidas: o JavaScript afeta a Velocidade de página. Os desenvolvedores não apenas dependem dele para fornecer interatividade, mas também há uma tendência de confiar nele para fornecer o próprio conteúdo. Isso melhora a experiência do desenvolvedor de algumas maneiras, mas os benefícios para os desenvolvedores nem sempre se traduzem em benefícios para os usuários.
Um padrão que pode derrotar o scanner de pré-carregamento é renderizar a marcação com JavaScript do lado do cliente:
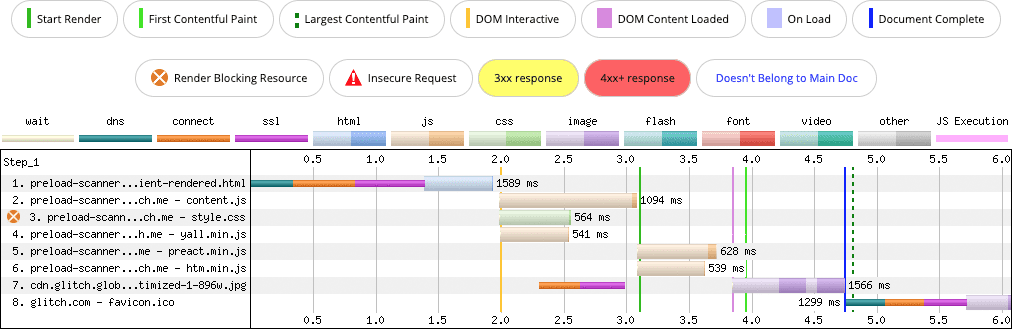
Quando os payloads de marcação são contidos e renderizados inteiramente pelo JavaScript no navegador, todos os recursos nessa marcação ficam invisíveis para o scanner de pré-carregamento. Isso atrasa a descoberta de recursos importantes, o que certamente afeta a LCP. No caso desses exemplos, a solicitação da imagem da LCP é significativamente atrasada em comparação com a experiência equivalente renderizada pelo servidor que não exige que o JavaScript apareça.
Isso se desvia um pouco do foco deste artigo, mas os efeitos da renderização de marcação no cliente vão muito além de derrotar o scanner de pré-carregamento. Por exemplo, introduzir o JavaScript para potencializar uma experiência que não o exige introduz um tempo de processamento desnecessário que pode afetar a Interaction to Next Paint (INP). Renderizar quantidades extremamente grandes de marcação no cliente tem mais chances de gerar tarefas longas em comparação com a mesma quantidade de marcação enviada pelo servidor. O motivo disso, além do processamento extra que o JavaScript envolve, é que os navegadores transmitem a marcação do servidor e dividem a renderização de uma forma que tende a limitar as tarefas longas. Por outro lado, a marcação renderizada pelo cliente é processada como uma única tarefa monolítica, o que pode afetar a INP de uma página.
A solução para esse cenário depende da resposta a esta pergunta: há algum motivo para a marcação da sua página não ser fornecida pelo servidor em vez de ser renderizada no cliente? Se a resposta for "não", considere usar a renderização do lado do servidor (SSR, na sigla em inglês) ou a marcação gerada estaticamente, quando possível, porque isso ajuda o scanner de pré-carregamento a descobrir e buscar recursos importantes com antecedência.
Se a página precisar de JavaScript para anexar funcionalidades a algumas partes da marcação, você ainda poderá fazer isso com SSR, seja com JavaScript vanilla ou hidratação para aproveitar o melhor dos dois mundos.
Ajuda o scanner de pré-carregamento a ajudar você
O scanner de pré-carregamento é uma otimização de navegador altamente eficaz que ajuda as páginas a carregar mais rápido durante a inicialização. Ao evitar padrões que impedem a descoberta de recursos importantes com antecedência, você não apenas simplifica o desenvolvimento, mas também cria experiências melhores para os usuários, o que vai gerar resultados melhores em muitas métricas, incluindo algumas Web Vitals.
Para recapitular, confira os principais pontos deste post:
- O scanner de pré-carregamento do navegador é um analisador de HTML secundário que faz uma verificação antes do principal se ele estiver bloqueado para descobrir recursos que podem ser buscados antes.
- Os recursos que não estão presentes na marcação fornecida pelo servidor na solicitação de navegação inicial não podem ser descobertos pelo scanner de pré-carregamento. As maneiras de derrotar o scanner de pré-carregamento podem incluir (mas não se limitam a):
- Injetar recursos no DOM com JavaScript, sejam scripts, imagens, folhas de estilo ou qualquer outra coisa que seria melhor no payload de marcação inicial do servidor.
- Carregamento lento de imagens ou iframes acima da dobra usando uma solução JavaScript.
- Renderização de marcação no cliente que pode conter referências a sub-recursos de documentos usando JavaScript.
- O scanner de pré-carregamento só verifica HTML. Ele não examina o conteúdo de outros recursos, principalmente CSS, que podem incluir referências a recursos importantes, incluindo candidatos à LCP.
Se, por qualquer motivo, você não puder evitar um padrão que afete negativamente a capacidade do scanner de pré-carregamento de acelerar o desempenho de carregamento, considere a dica de recurso rel=preload. Se você usar o rel=preload, faça testes em ferramentas de laboratório para garantir que ele esteja produzindo o efeito desejado. Por fim, não pré-carregue muitos recursos, porque, quando você prioriza tudo, nada é priorizado.
Recursos
- "Scripts assíncronos" injetados por script considerados prejudiciais
- Como o pré-carregador do navegador acelera o carregamento de páginas
- Pré-carregue recursos essenciais para melhorar a velocidade de carregamento
- Estabelecer conexões de rede com antecedência para melhorar a Velocidade de página percebida
- Otimizar a Largest Contentful Paint